LangChain - Vector Stores
向量概念
向量是文本的“数学身份证”:将语义信息转换成一串固定长度的数字列表,让计算机能“看懂”文字的含义并做相似度计算。
向量嵌入
文本嵌入模型通过深度学习等技术**,从文本提取语义特征并映射为固定长度的数字序列**。
如何更为精准的完成语义匹配,生成向量的维度是一个很重要的指标。
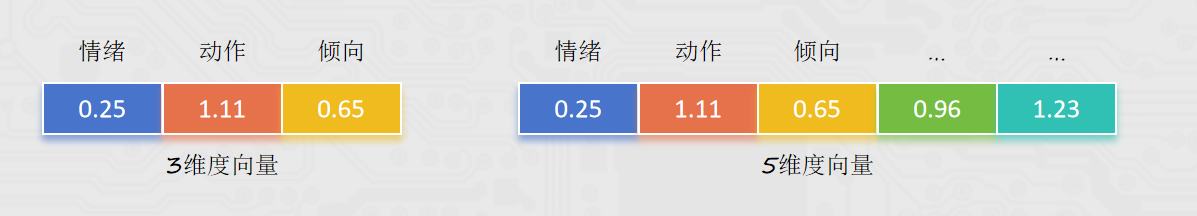
如text-embedding-v1模型,可以生成1536维的向量(一段文本固定得到1536个数字序列),比较实用。
- 1536个数字表示,这段文本在1536个主题(抽象的语义特征)方向上的得分(强度)
- 生成向量的维度越多,就更好的记录文本的语义特征,做语义匹配会更加精准。
- 更多的向量会在计算、存储和匹配过程中,带来更大的压力。
选择合适的向量维度需要在精确和性能之间做平衡。一般1536维算是比较好的选择。
向量匹配
在向量匹配的过程中,如何识别2段文本是否表述相似的含义,主要可以通过如余弦相似度等算法来完成。
比如:
A:如何快速学会打篮球? —— [0.2, 0.5, 0.8]:
B:打篮球怎么学比较快? —— [0.18, 0.52, 0.79]
C:运动后吃什么好呢? —— [0.9, 0.1, 0.2]
通过余弦相似度算法可以计算得到:A和B相似度0.999789,A和C相似度0.361446。
余弦相似度
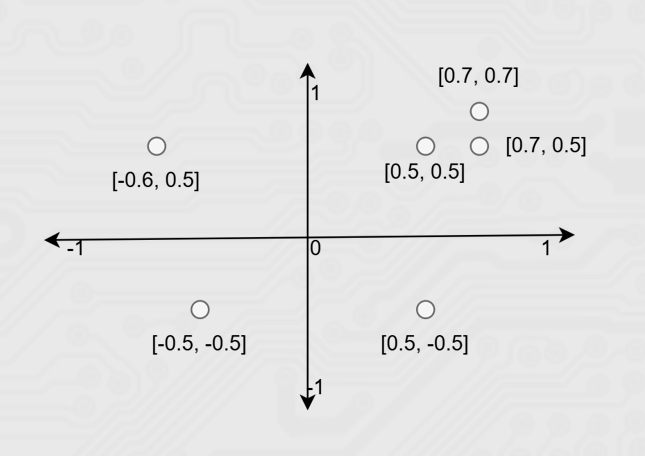
向量的数字序列,共同决定了向量在高维空间中的方向和长度。而余弦相似度主要就是撇除长度的影响,得到方向的夹角。———— 只关注方向
例如: [0.5, 0.5] 和 [0.7, 0.7] 是同向不同长
向量存储
LangChain内提供向量存储功能,可以基于:
- InMemoryVectorStore,完成内存向量存储
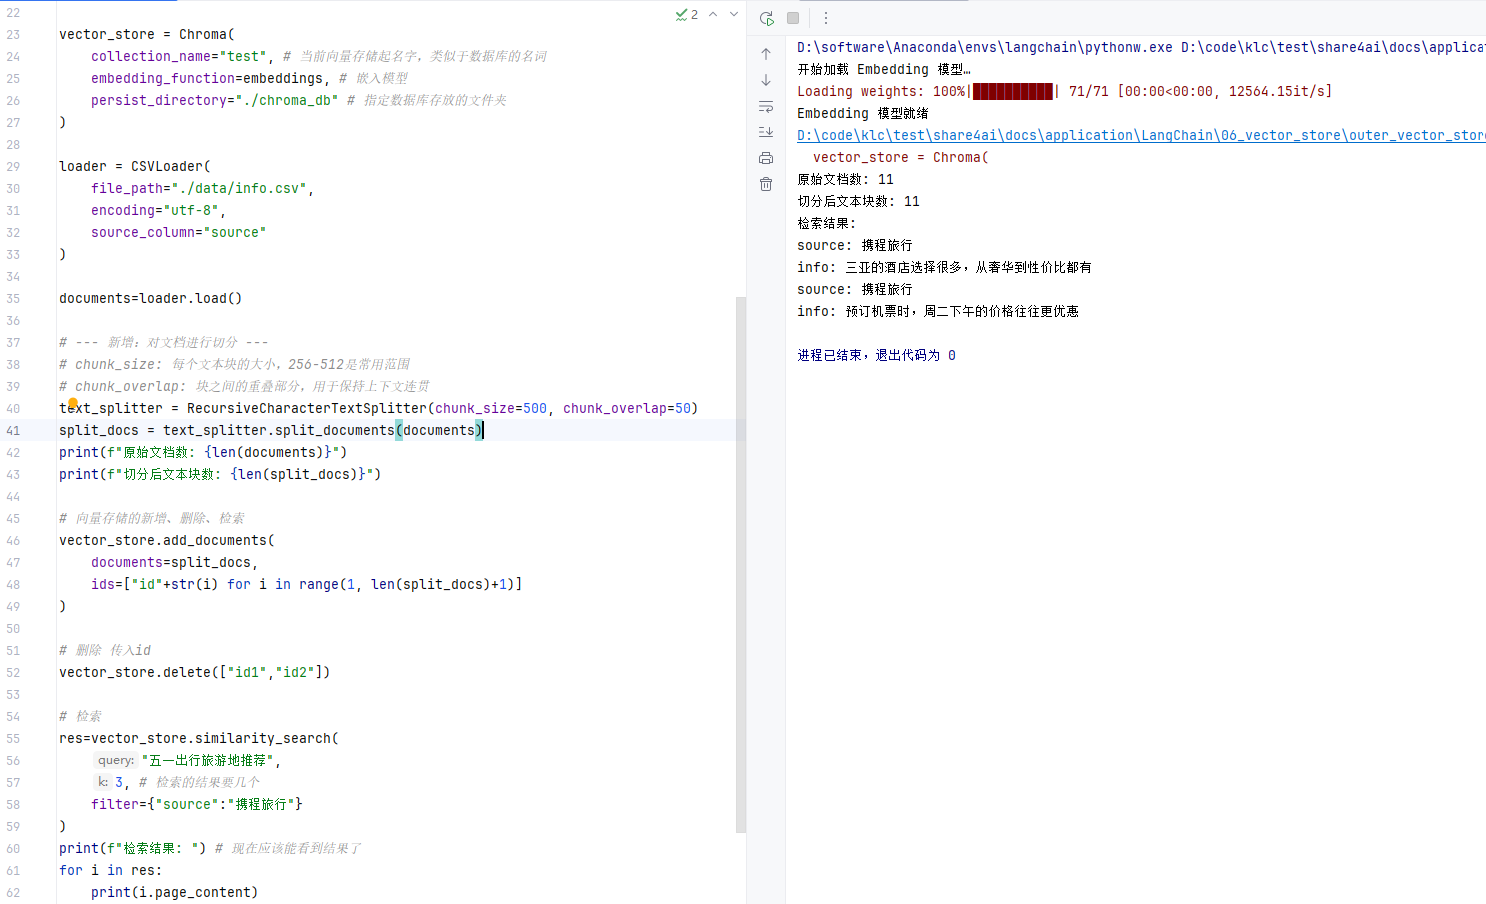
- Chroma,外部数据库向量存储
向量存储类均提供3个通用API接口:
- add_document,添加文档到向量存储
- delete,从向量存储中删除文档
- similarity_search:相似度搜索
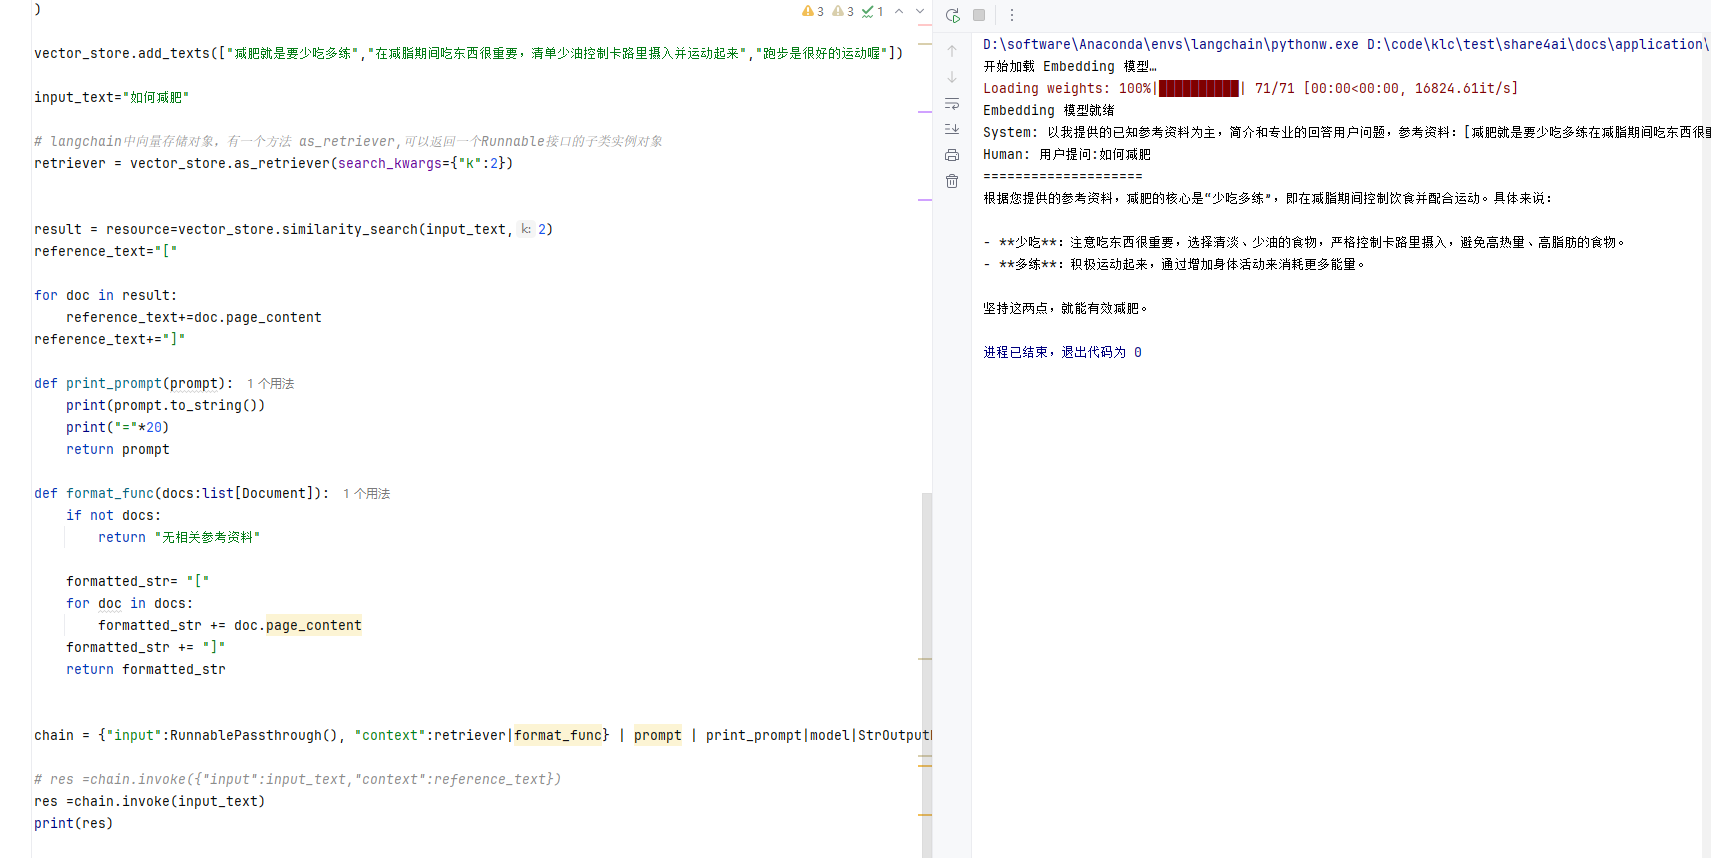
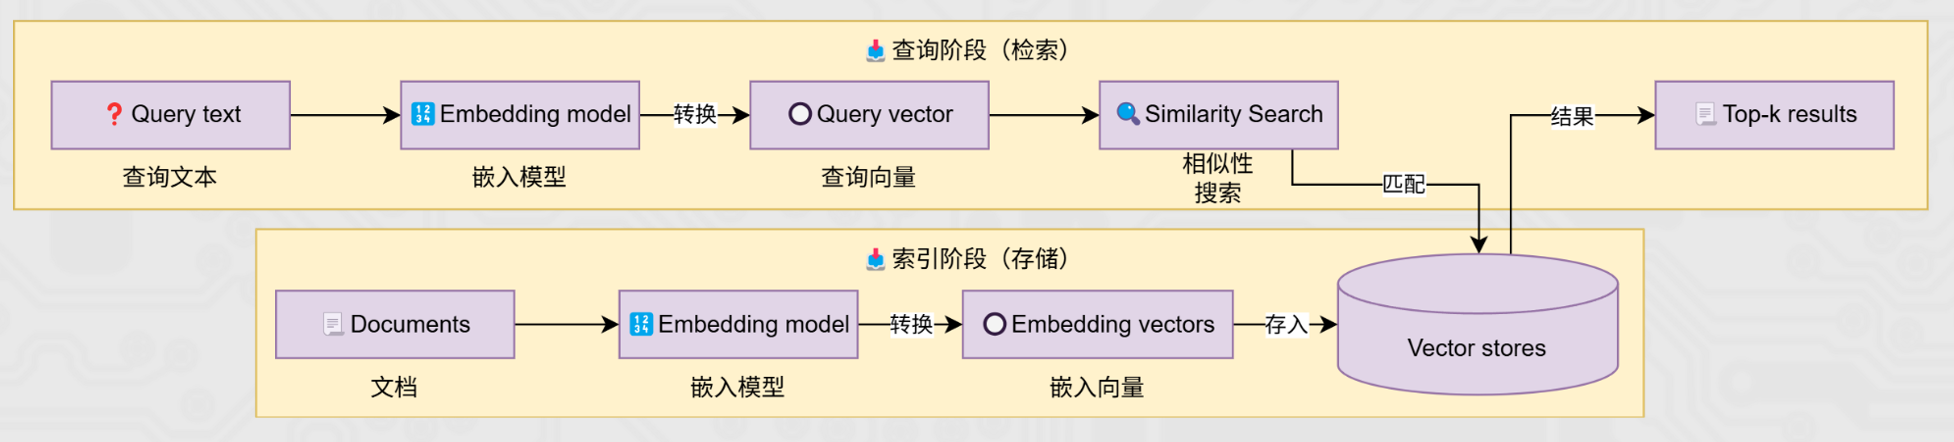
整体向量存储使用流程如下(RAG流程):
- 基于LangChain的向量存储,存储嵌入数据,并执行相似性搜索。
内置向量存储
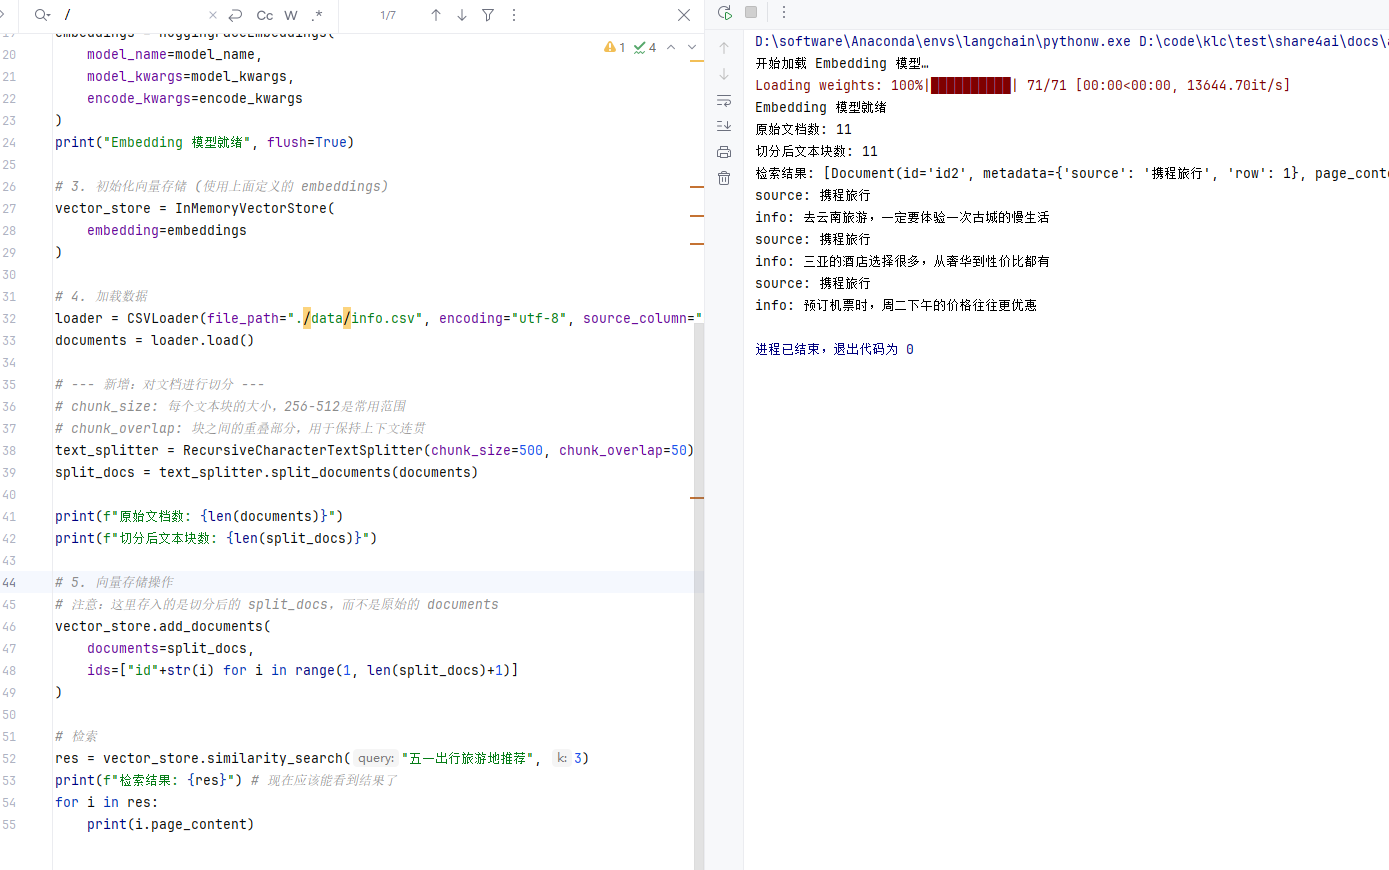
使用InMemoryVectorStore完成内置向量的存储
外部(Chroma)向量存储
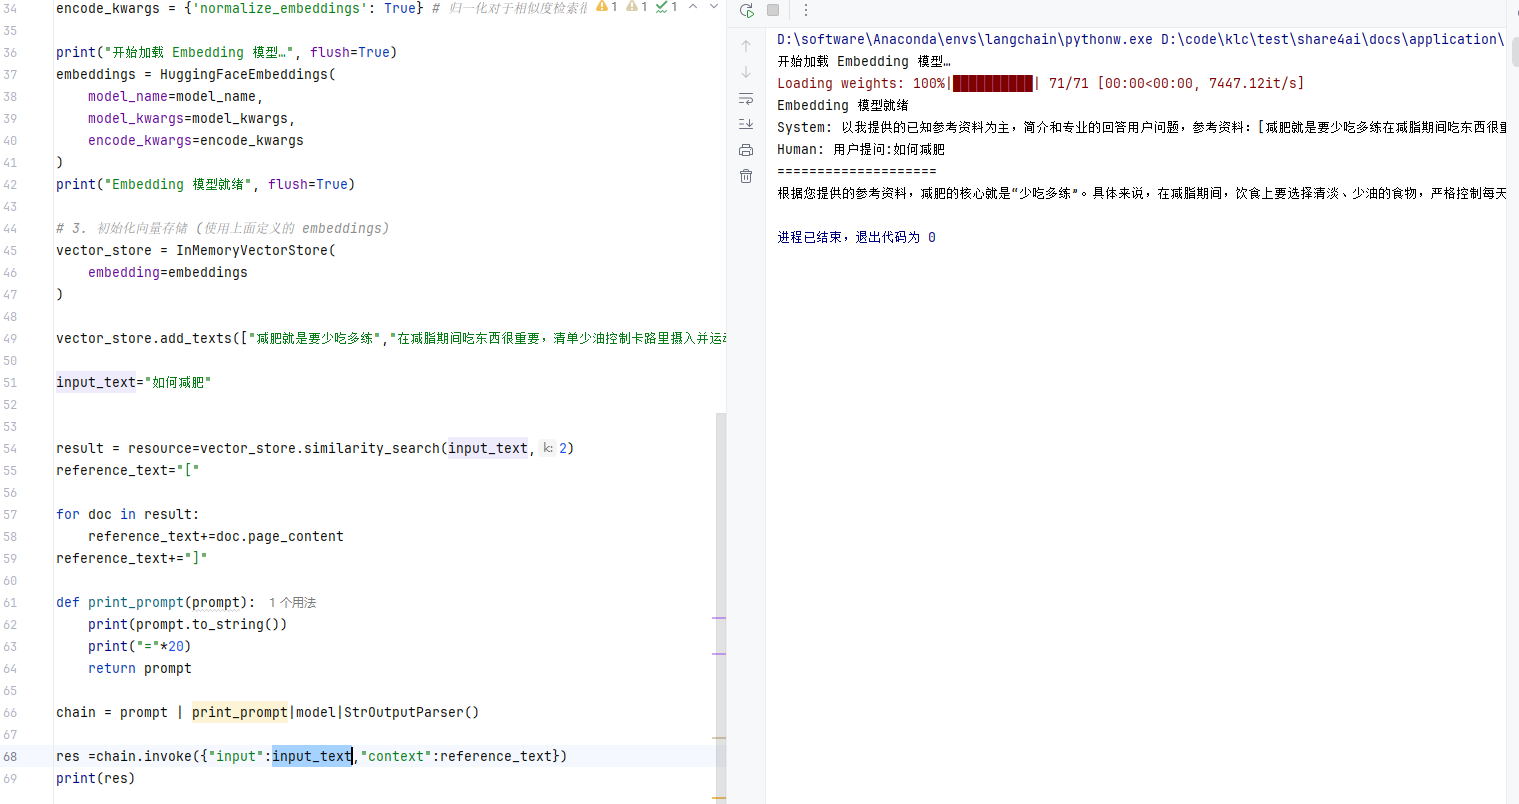
向量检索构建提示词
RunnablePassthrouth的使用