AI知识分享AI知识分享
✿导航
  • 人工智能
  • 神经网络
  • 机器学习
  • 深度学习
  • 强化学习
  • 自然语言处理
  • 计算机视觉
  • 数学基础
  • 大模型基础
  • 动手学深度学习
  • 理论理解
  • 工程实践
  • 应用开发
  • AI For Everyone
  • AIGC_2024大会
  • AIGC_2025大会
  • Agentic AI
  • Transformer
  • PyTorch
  • HuggingFace
  • LangChain
  • 蒸馏
  • RAG
  • 目标检测
  • MCP
  • Cursor
  • 概念
  • 意图识别
  • 工具
  • 学习路线
  • PyTorch 资料
  • 公式学习
  • PyTorch 基础练习
✿导航
  • 人工智能
  • 神经网络
  • 机器学习
  • 深度学习
  • 强化学习
  • 自然语言处理
  • 计算机视觉
  • 数学基础
  • 大模型基础
  • 动手学深度学习
  • 理论理解
  • 工程实践
  • 应用开发
  • AI For Everyone
  • AIGC_2024大会
  • AIGC_2025大会
  • Agentic AI
  • Transformer
  • PyTorch
  • HuggingFace
  • LangChain
  • 蒸馏
  • RAG
  • 目标检测
  • MCP
  • Cursor
  • 概念
  • 意图识别
  • 工具
  • 学习路线
  • PyTorch 资料
  • 公式学习
  • PyTorch 基础练习
  • 人工智能

    • 人工智能 - 概念
  • 神经网络

    • 神经网络 - 基础
    • 神经网络 - 激活函数
    • 神经网络 - 前馈神经网络
    • 神经网络 - 卷积神经网络
    • 神经网络 - 循环神经网络
    • 神经网络 - 机器学习
    • 神经网络 - 线性模型
  • 机器学习

    • 机器学习 - 概念
    • 机器学习 - 基础
  • 深度学习

    • 深度学习 - 概念
  • 强化学习

    • 强化学习 - 概念
  • 自然语言处理

    • 自然语言处理 - 概念
  • 计算机视觉

    • 计算机视觉 - 概念
  • 数学基础

    • 数学基础
    • 神经网络相关
    • 向量相似度 / RAG

数学基础

参考资料

  • 模型训练中的梯度下降法

导数

导数用于描述函数在某一点处的瞬时变化率。它反映了函数值随自变量变化的敏感程度,广泛应用于物理、工程、经济学等领域。例如瞬间速度、切线斜率等。

定义

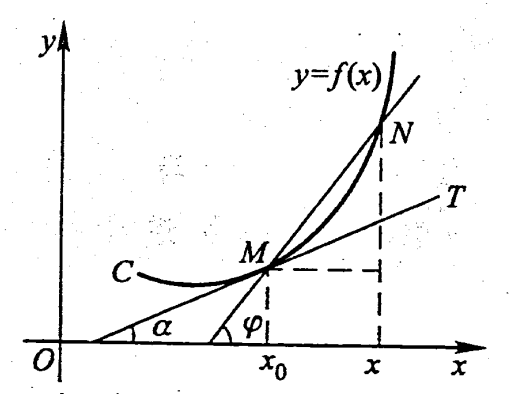
  • 几何意义:函数 f(x) f(x) f(x) 在点 x0 x_0 x0​ 处的导数是其图像在该点的切线斜率。

  • 数学定义(极限形式):

f′(x0)=lim⁡h→0f(x0+h)−f(x0)hf'(x_0) = \lim_{h \to 0} \frac{f(x_0 + h) - f(x_0)}{h} f′(x0​)=h→0lim​hf(x0​+h)−f(x0​)​

若该极限存在,则称 f(x) f(x) f(x) 在 x0 x_0 x0​ 处可导。

常见表示符号

  • 莱布尼茨记号:dydx \frac{dy}{dx} dxdy​ 或 dfdx \frac{df}{dx} dxdf​。
  • 拉格朗日记号:f′(x) f'(x) f′(x)。
  • 牛顿记号:y˙ \dot{y} y˙​(常用于时间导数)。

偏导数

偏导数用于描述函数在某一自变量方向上的变化率,而其他自变量保持不变。它在优化、物理场分析、经济学等多变量系统中广泛应用。

定义

对于多元函数 f(x1,x2,…,xn) f(x_1, x_2, \dots, x_n) f(x1​,x2​,…,xn​),其在点 (a1,a2,…,an) (a_1, a_2, \dots, a_n) (a1​,a2​,…,an​) 处关于 xi x_i xi​ 的偏导数定义为:

∂f∂xi=lim⁡h→0f(a1,…,ai+h,…,an)−f(a1,…,ai,…,an)h\frac{\partial f}{\partial x_i} = \lim_{h \to 0} \frac{f(a_1, \dots, a_i + h, \dots, a_n) - f(a_1, \dots, a_i, \dots, a_n)}{h} ∂xi​∂f​=h→0lim​hf(a1​,…,ai​+h,…,an​)−f(a1​,…,ai​,…,an​)​

即:仅让 xi x_i xi​ 变化,其他变量视为常数,再求普通导数。

几何意义

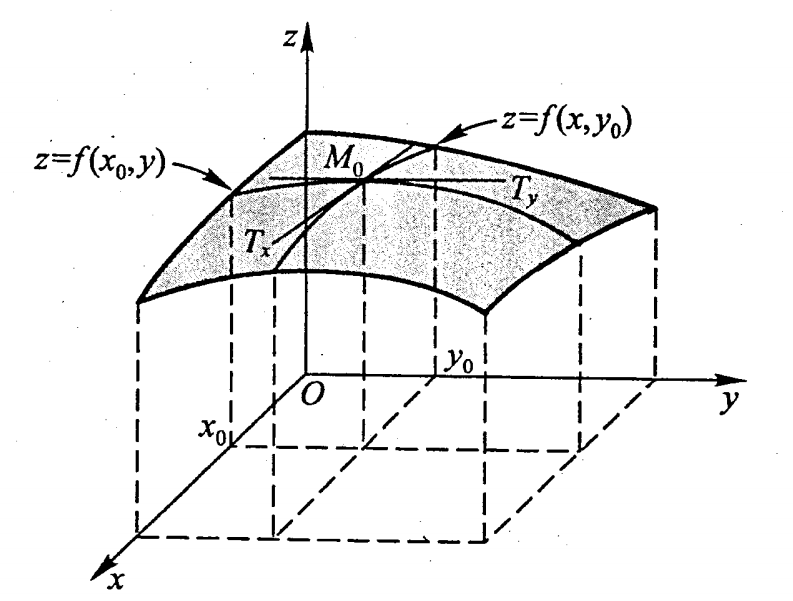
  • 二元函数 z=f(x,y) z = f(x,y) z=f(x,y) 的偏导数 ∂f∂x \frac{\partial f}{\partial x} ∂x∂f​ 表示曲面在 x x x 方向的切线斜率(固定 y y y)。

  • 类似地,∂f∂y \frac{\partial f}{\partial y} ∂y∂f​ 是 y y y 方向的切线斜率。

应用场景

  • 梯度(Gradient):由所有偏导数组成的向量,指向函数增长最快的方向。

    ∇f=(∂f∂x,∂f∂y,∂f∂z).\nabla f = \left( \frac{\partial f}{\partial x}, \frac{\partial f}{\partial y}, \frac{\partial f}{\partial z} \right). ∇f=(∂x∂f​,∂y∂f​,∂z∂f​).

  • 优化问题:如机器学习中的梯度下降法,利用偏导数调整参数。
  • 物理场分析:如温度场 T(x,y,z) T(x,y,z) T(x,y,z) 的偏导表示热流方向。

偏导数 vs 全导数

  • 偏导数:针对多元函数,仅一个变量变化。
  • 全导数:适用于复合函数,所有变量可能同时依赖另一个变量(如时间 t t t):

    dfdt=∂f∂xdxdt+∂f∂ydydt.\frac{df}{dt} = \frac{\partial f}{\partial x} \frac{dx}{dt} + \frac{\partial f}{\partial y} \frac{dy}{dt}. dtdf​=∂x∂f​dtdx​+∂y∂f​dtdy​.

梯度

梯度是多元函数的一阶导数推广,它是一个向量,表示函数在某一点处增长最快的方向,其大小(模长)表示该方向上的变化率。

数学定义

对于 n n n 元函数 f(x1,x2,…,xn) f(x_1, x_2, \dots, x_n) f(x1​,x2​,…,xn​),其梯度记作 ∇f \nabla f ∇f,定义为:

∇f=(∂f∂x1,∂f∂x2,…,∂f∂xn)\nabla f = \left( \frac{\partial f}{\partial x_1}, \frac{\partial f}{\partial x_2}, \dots, \frac{\partial f}{\partial x_n} \right) ∇f=(∂x1​∂f​,∂x2​∂f​,…,∂xn​∂f​)

即,梯度是所有偏导数组成的向量。

几何意义

  • 方向:梯度指向函数在该点处增长最快的方向。
  • 大小(模长):梯度的模 ∥∇f∥ \|\nabla f\| ∥∇f∥ 表示该方向上的变化率(即最大增长率)。
  • 等高线(等值面):
    • 在二维情况下,梯度与等高线(f(x,y)=C f(x,y) = C f(x,y)=C)垂直。
    • 在三维情况下,梯度与等值面(f(x,y,z)=C f(x,y,z) = C f(x,y,z)=C)垂直。

梯度的应用

梯度下降法(优化算法)

设目标函数为 J(θ) J(\theta) J(θ)(例如机器学习中的损失函数),我们要找到参数 θ \theta θ 使 J(θ) J(\theta) J(θ) 最小。

更新公式

θnew=θold−α⋅∇J(θold)\theta_{\text{new}} = \theta_{\text{old}} - \alpha \cdot \nabla J(\theta_{\text{old}}) θnew​=θold​−α⋅∇J(θold​)

  • θ \theta θ:待优化的参数(如模型权重)。
  • α \alpha α:学习率(步长),控制每次更新的幅度。
  • ∇J(θ) \nabla J(\theta) ∇J(θ):梯度,表示函数在 θ \theta θ 处的“最陡上升方向”。
    • 负梯度(−∇J -\nabla J −∇J)就是“最陡下降方向”。

梯度下降的步骤

  1. 初始化:随机选择起始参数 θ0 \theta_0 θ0​(比如设 θ=0 \theta=0 θ=0)。
  2. 计算梯度:求当前点的梯度 ∇J(θ) \nabla J(\theta) ∇J(θ)。
  3. 更新参数:沿负梯度方向调整参数:θ←θ−α∇J(θ) \theta \leftarrow \theta - \alpha \nabla J(\theta) θ←θ−α∇J(θ)。
  4. 重复:直到梯度接近零(收敛)或达到最大迭代次数。

它的核心思想是:“沿着梯度的反方向,一步步往下走,直到找到最低点。”

示例:

参见matrix.py内容,执行结果:

=== 训练结束 ===

真实权重 W_true:
[[ 2.]
 [-1.]
 [ 3.]],
真实偏置 b_true:
[1.]

学习到的权重 W:
[[ 1.99506683]
 [-1.00083223]
 [ 2.99882457]],
学习到的偏置 b:
[1.00097798]

(pytorch) D:\code\klc\test\share4ai\docs\basic\math>

方向导数(Directional Derivative)

是多元函数在某一点沿指定方向的变化率,它扩展了偏导数的概念(偏导数是方向导数的特例,沿坐标轴方向)。

数学定义

设函数 f(x1,x2,…,xn) f(x_1, x_2, \dots, x_n) f(x1​,x2​,…,xn​) 在点 a=(a1,a2,…,an) \mathbf{a} = (a_1, a_2, \dots, a_n) a=(a1​,a2​,…,an​) 处可微,方向向量 u=(u1,u2,…,un) \mathbf{u} = (u_1, u_2, \dots, u_n) u=(u1​,u2​,…,un​)(需为单位向量,即 ∥u∥=1 \|\mathbf{u}\| = 1 ∥u∥=1),则 f f f 在 a \mathbf{a} a 点沿 u \mathbf{u} u 的方向导数为:

Duf(a)=∇f(a)⋅u=∂f∂x1u1+∂f∂x2u2+⋯+∂f∂xnunD_{\mathbf{u}} f(\mathbf{a}) = \nabla f(\mathbf{a}) \cdot \mathbf{u} = \frac{\partial f}{\partial x_1} u_1 + \frac{\partial f}{\partial x_2} u_2 + \dots + \frac{\partial f}{\partial x_n} u_n Du​f(a)=∇f(a)⋅u=∂x1​∂f​u1​+∂x2​∂f​u2​+⋯+∂xn​∂f​un​

其中 ∇f(a) \nabla f(\mathbf{a}) ∇f(a) 是梯度,⋅ \cdot ⋅ 表示点积。表明方向导数是梯度向量在方向 u \mathbf{u}u上的投影。

几何意义

  • 方向导数表示函数沿方向 u \mathbf{u} u 的瞬时变化率。
  • 最大值:当 u \mathbf{u} u 与梯度 ∇f \nabla f ∇f 同向时,方向导数最大(等于梯度的模 ∥∇f∥ \|\nabla f\| ∥∇f∥)。
  • 最小值:当 u \mathbf{u} u 与梯度反向时,方向导数最小(等于 −∥∇f∥ -\|\nabla f\| −∥∇f∥)。
  • 零值:当 u \mathbf{u} u 与梯度垂直时,方向导数为零(表示该方向无变化)。
最近更新: 2026/3/25 20:50
Contributors: klc407073648
Next
神经网络相关