
LangChain - RAG基础
理解什么是 RAG
通用的基础大模型存在的一些问题:
- LLM的知识不是实时的,模型训练好后不具备自动更新知识的能力,会导致部分信息滞后;
- LLM领域知识是缺乏的,大模型的知识来源于训练数据,这些数据主要来自公开的互联网和开源数据集,无法覆盖特定领域或高度专业化的内部知识
- 幻觉问题,LLM有时会在回答中生成看似合理但实际上是错误的信息
- 数据安全性
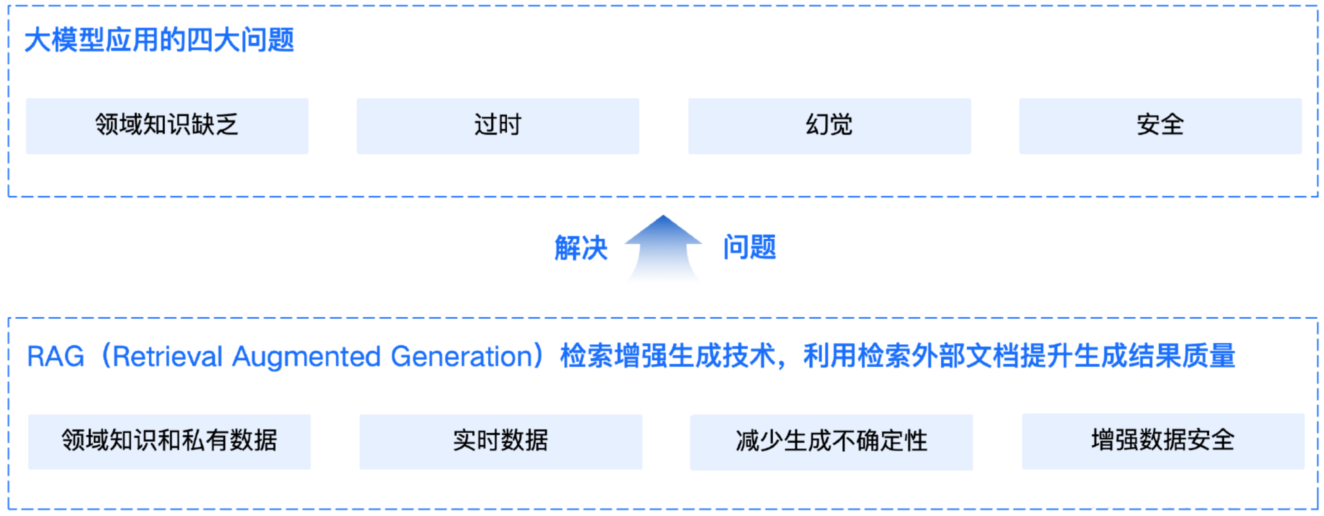
RAG(Retrieval-Augmented Generation):检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。
RAG 的工作原理
工作流程图解:
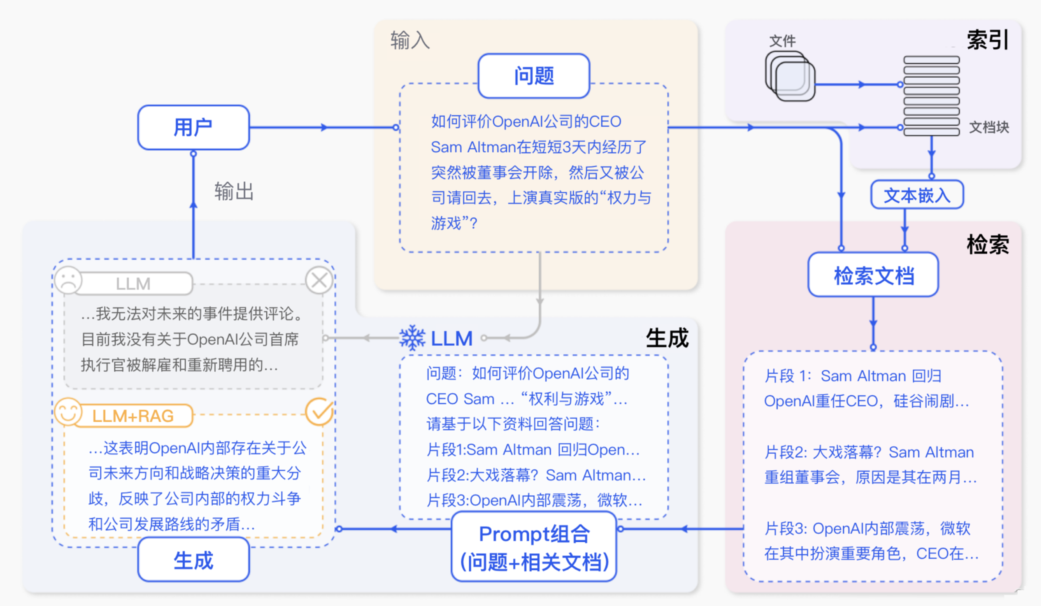
RAG标准流程:
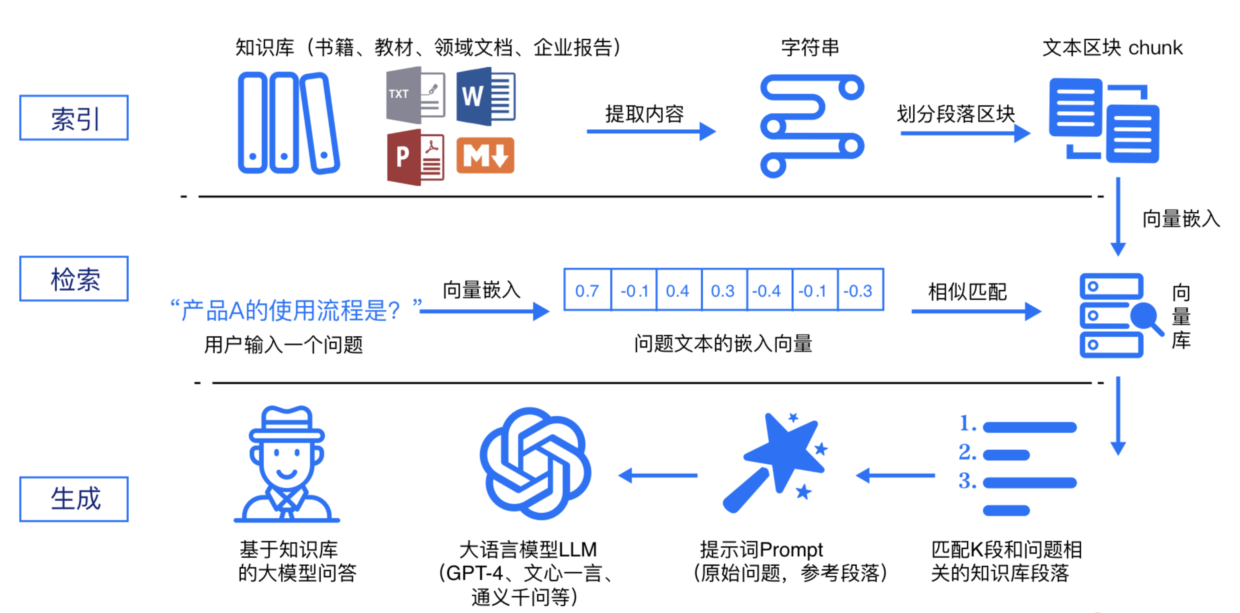
标准流程
- 离线准备 / 在线服务
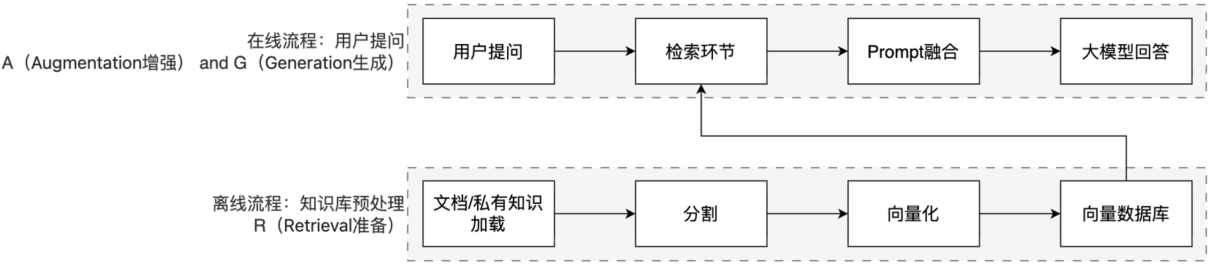
RAG 标准流程由索引(Indexing)、检索(Retriever)和生成(Generation)三个核心阶段组成。
- 索引阶段,通过处理多种来源多种格式的文档提取其中文本,将其切分为标准长度的文本块(chunk),并进行嵌入向量化(embedding),向量存储在向量数据库(vector database)中。
- 加载文件
- 内容提取
- 文本分割 ,形成chunk
- 文本向量化
- 存向量数据库
- 检索阶段,用户输入的查询(query)被转化为向量表示,通过相似度匹配从向量数据库中检索出最相关的文本块。
- query向量化
- 在文本向量中匹配出与问句向量相似的top_k个
- 生成阶段,检索到的相关文本与原始查询共同构成提示词(Prompt),输入大语言模型(LLM),生成精确且具备上下文关联的回答。
- 匹配出的文本作为上下文和问题一起添加到prompt中
- 提交给LLM生成答案:
RAG 的核心价值
- 解决知识实效性问题:接入最新文档,让模型输出“与时俱进”
- 降低模型幻觉:回答基于事实性资料,减少编造信息
- 无需重新训练模型:成本更低、效率更高