
创建工具
LLM本身并不会直接执行代码或调用函数,它被训练的核心能力是生成文本。 如何让LLM学会调用函数的过程,核心思想是模型不直接调用,而是“请求”调用。工具其实就是一些代码/函数。如今的主流语言模型都经过直接训练去使用工具,没有训练就必须得写提示词来告诉模型如何使用工具。
早期方法(手动提示工程):
在 LLM 尚未被直接训练来使用工具时,开发者必须通过编写详细的系统提示词来“告诉” LLM 如何请求调用工具。
例如,指示 LLM 在需要调用
get_current_time工具时,必须输出特定格式的文本:“FUNCTION: get_current_time()”。这种方法虽然有效,但需要开发者手动处理 LLM 的输出,解析其意图,然后执行相应的函数。
现代方法:
- 当前主流的 LLM 都经过了直接训练,能够原生地理解何时以及如何请求调用工具。
- 开发者不再需要像过去那样在提示词中硬编码特定的触发语法(如全大写的 “FUNCTION”),而是只需向 LLM 提供工具的描述和可用性,模型会自行决定何时调用。
实现工具使用:
- 开发者编写工具函数:例如 get_current_time()。
- 开发者编写系统提示词 (System Prompt):告诉模型,如果它想使用某个工具,应该如何格式化它的输出。
- 模型根据提示词输出特定格式的文本:这个文本不是最终答案,而是一个“请求”,例如 FUNCTION: get_current_time()。
- 开发者编写解析代码:读取模型的输出,识别出这个“请求”,然后真正地调用对应的函数。
- 将函数结果回传给模型:把函数返回的结果作为新的上下文输入给模型,让它生成最终的自然语言回复。
就像你不能直接命令一个只会说话的人去帮你买咖啡,但你可以告诉他:“如果你想去买咖啡,请说‘我要买一杯美式’。” 然后你听到这句话后,自己去帮他买。
手动提示工程方法详解
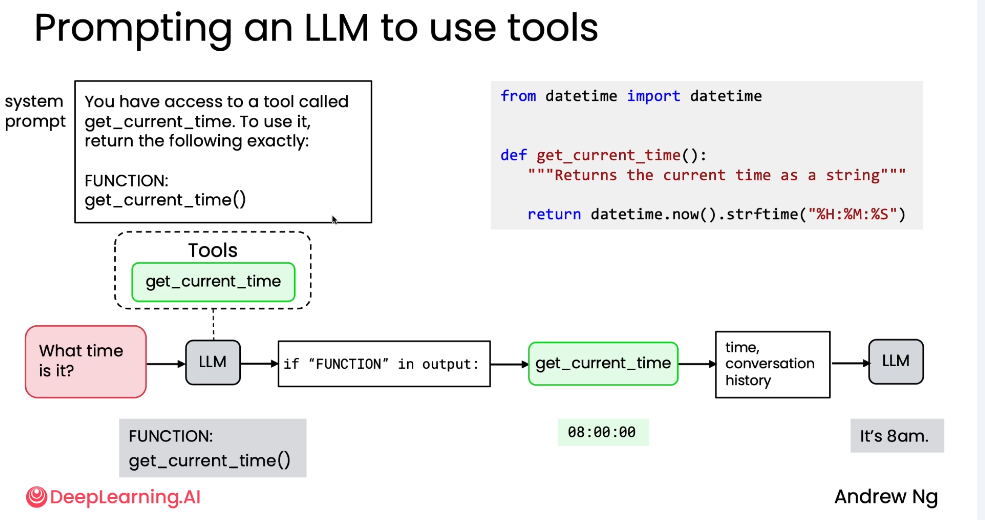
以 get_current_time 工具为例,展示完整的交互流程:
步骤一:提供工具和系统提示
- 实现工具:开发者编写好
get_current_time()函数。 - 设计系统提示 (System Prompt):编写一个提示词,明确告知 LLM 它可以访问这个工具,并规定调用它的精确格式。
You have access to a tool called get_current_time. To use it, return the following exactly:
FUNCTION: get_current_time()
步骤二:用户提问与模型响应
- 用户提问:“What time is it?”
- LLM 决策:LLM 分析问题后,意识到需要获取当前时间。
- LLM 输出:根据系统提示的要求,LLM 不会直接回答,而是输出预设的触发文本:
FUNCTION: get_current_time()
步骤三:开发者代码介入
- 解析输出:开发者编写的程序读取 LLM 的输出。
- 识别意图:检查输出中是否包含 “FUNCTION” 关键字。
- 提取参数:如果包含,则提取出要调用的函数名
get_current_time及其参数(此例中无参数)。 - 执行工具:程序实际调用
get_current_time()函数,获得返回值(如"08:00:00")。
步骤四:反馈结果并生成最终答案
- 构建对话历史:将工具的执行结果(如
"08:00:00")连同之前的对话历史(用户问题、LLM 的函数请求)一起,作为新的上下文输入给 LLM。 - LLM 生成最终回复:LLM 接收到包含工具执行结果的新上下文后,知道之前发生了什么(用户问时间 -> LLM 请求调用函数 -> 函数返回了“8点”),于是生成自然语言的最终回复:“It's 8am.”
处理带参数的工具
当工具函数需要参数时,流程类似,但提示词和 LLM 的输出需要包含参数信息。
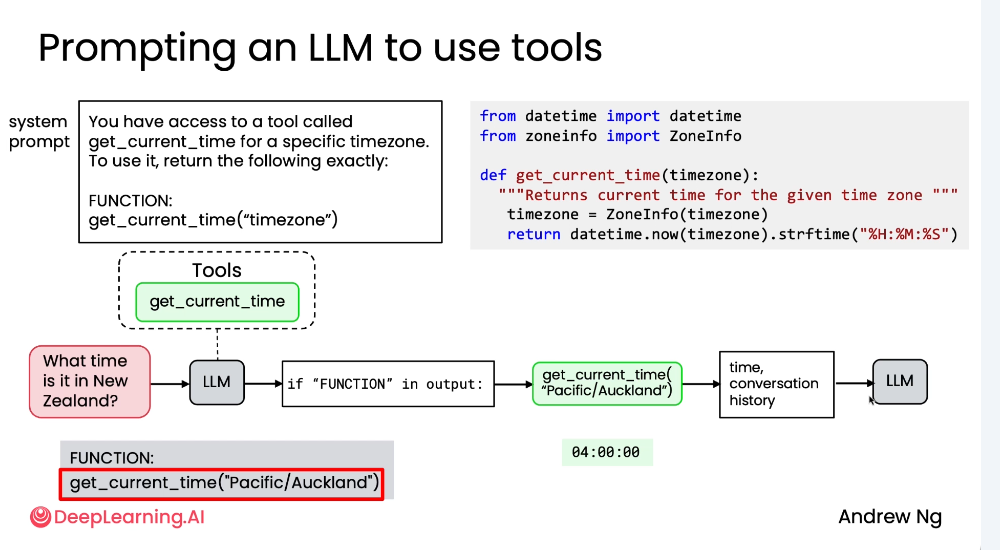
示例:获取指定时区的时间
- 实现工具:编写一个带参数的函数
get_current_time(timezone)。 - 修改系统提示:
You have access to a tool called get_current_time for a specific timezone. To use it, return the following exactly: FUNCTION: get_current_time("timezone") - 用户提问:“What time is it in New Zealand?”
- LLM 输出:LLM 会根据提示格式,输出带有具体参数的文本:
FUNCTION: get_current_time("Pacific/Auckland") - 开发者代码:解析出函数名和参数
"Pacific/Auckland",然后调用get_current_time("Pacific/Auckland")。 - 反馈与回复:将执行结果(如
"04:00:00")反馈给 LLM,最终 LLM 回复:“It's 4am in New Zealand.”
总结:工具使用的核心流程 四步循环:
- 提供工具 (Provide the Tool):开发者编写好功能函数。
- 告知模型 (Tell the LLM):通过系统提示词,明确告诉模型有哪些工具可用,以及如何“请求”调用它们(即输出什么格式的文本)。
- 解析并执行 (Parse and Execute):开发者编写代码,监听模型的输出,识别其“请求”,并实际执行对应的函数。
- 反馈结果 (Feed Back Result):将函数执行的结果作为新的上下文,送回给模型,让它继续推理或生成最终答案。 这个流程的关键在于,开发者扮演了“翻译官”和“执行者”的角色,弥合了语言模型的“文本生成”能力与现实世界“函数执行”能力之间的鸿沟。