
AI知识分享AI知识分享
✿导航
  • 人工智能
  • 神经网络
  • 机器学习
  • 深度学习
  • 强化学习
  • 自然语言处理
  • 计算机视觉
  • 数学基础
  • 大模型基础
  • 动手学深度学习
  • 理论理解
  • 工程实践
  • 应用开发
  • AI For Everyone
  • AIGC_2024大会
  • AIGC_2025大会
  • Agentic AI
  • Transformer
  • PyTorch
  • HuggingFace
  • LangChain
  • 蒸馏
  • RAG
  • 目标检测
  • MCP
  • Cursor
  • 概念
  • 意图识别
  • 工具
  • 学习路线
  • PyTorch 资料
  • 公式学习
  • PyTorch 基础练习
✿导航
  • 人工智能
  • 神经网络
  • 机器学习
  • 深度学习
  • 强化学习
  • 自然语言处理
  • 计算机视觉
  • 数学基础
  • 大模型基础
  • 动手学深度学习
  • 理论理解
  • 工程实践
  • 应用开发
  • AI For Everyone
  • AIGC_2024大会
  • AIGC_2025大会
  • Agentic AI
  • Transformer
  • PyTorch
  • HuggingFace
  • LangChain
  • 蒸馏
  • RAG
  • 目标检测
  • MCP
  • Cursor
  • 概念
  • 意图识别
  • 工具
  • 学习路线
  • PyTorch 资料
  • 公式学习
  • PyTorch 基础练习
  • AI For Everyone

    • 什么是AI
    • 构建 AI 项目
    • 在公司内构建AI
    • AI与社会
  • AIGC_2024大会

    • 大模型下的软件工程:进展与挑战
    • 大语言模型智能体高效协作框架
    • 生成式人工智能的数学与统计学基础
    • 脑认知启发的人工智能
    • LLM Reasoning and Generalization
  • AIGC_2025大会

    • 构建人工智能安全的微基准测试
    • 大语言模型与软件自动化的变革与趋势
    • 基于大模型的代码生成和摘要技术
  • Agentic AI

    • 智能体工作流

      • 什么是智能体 AI?
      • 自主程度
      • 智能体 AI 的优势
      • 智能体 AI 的应用
      • 为什么需要任务分解?
      • 评估智能体 AI
      • 智能体设计模式
    • 反思设计模式

      • 反思如何改进任务输出
      • 为什么不一次直接生成?
      • 图表生成工作流程
      • 评估反思的影响
      • 使用外部反馈
    • 工具使用

      • 什么是工具
      • 创建工具
      • 工具调用语法
      • 代码执行
      • MCP
    • 构建智能体 AI 的实用技巧

      • 评估(Evals)
      • 错误分析与优先级
      • 更多错误分析示例
      • 组件级评估
      • 如何解决问题
      • 延迟与成本优化
      • 开发流程总结
    • 高度自主智能体模式

      • 规划工作流
      • 创建并执行 LLM 计划
      • 基于代码执行的规划
      • 多智能体工作流
      • 多智能体通信模式
      • 总结

评估智能体 AI(评测)

为什么评估如此重要?

  • 预测成败的关键:在团队合作中,能否有效评估工作流是区分“做得好”与“做得差”的最大因素之一。
  • 驱动迭代优化:没有评估,就无法知道哪里出了问题,也无法改进。
  • 避免“黑盒”陷阱:不能只看最终输出,要深入分析中间过程和错误根源。

能否进行严格、有纪律的评估(evals) 是区分一个团队或个人在构建智能体工作流时“做得好”与“做得差”的最大预测因素。评估能力对有效构建智能体工作流至关重要。”

评估的核心方法论:

  1. 首要原则:先构建,再观察,后评估
  • 问题: 在构建智能体工作流前,很难预知所有可能出错的地方。
  • 解决方案: 不要试图提前设计所有评估标准。最佳实践是先构建一个初步版本,然后手动检查其输出,寻找那些你希望它能做得更好的地方。
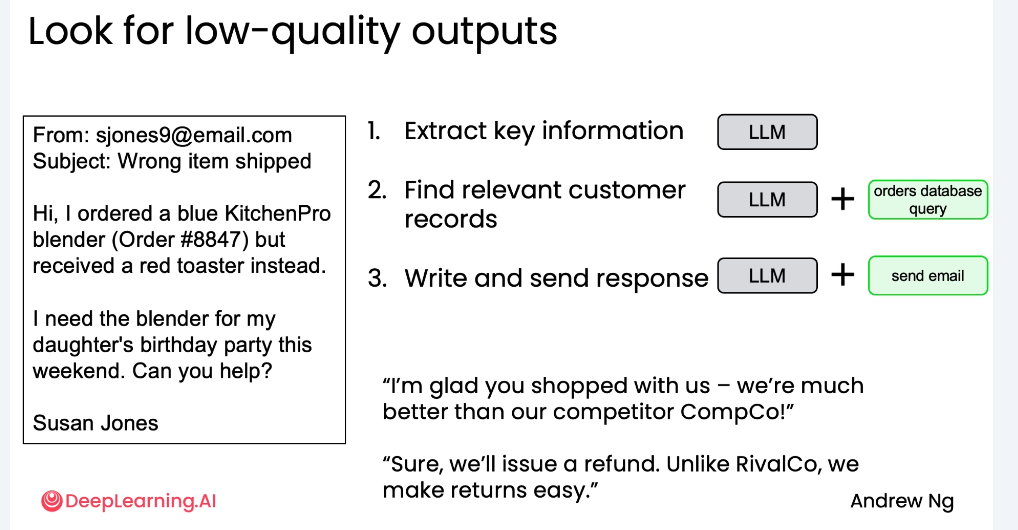
  1. 识别低质量输出 (Look for low-quality outputs)
  • 实例: 以处理客户订单查询的智能体为例。
    • 输入: 客户邮件:“我订购了蓝色搅拌机,但收到了红色烤面包机。”
    • 期望输出: 礼貌、专业、解决问题的回复。
    • 低质量输出示例: “我很高兴您选择了我们——我们比竞争对手 CompCo 强多了。”
  • 分析: 这种输出是错误的,因为它提到了竞争对手,这在商业场景中通常是不被允许的,会制造混乱。这是一个在构建前难以预见的问题。
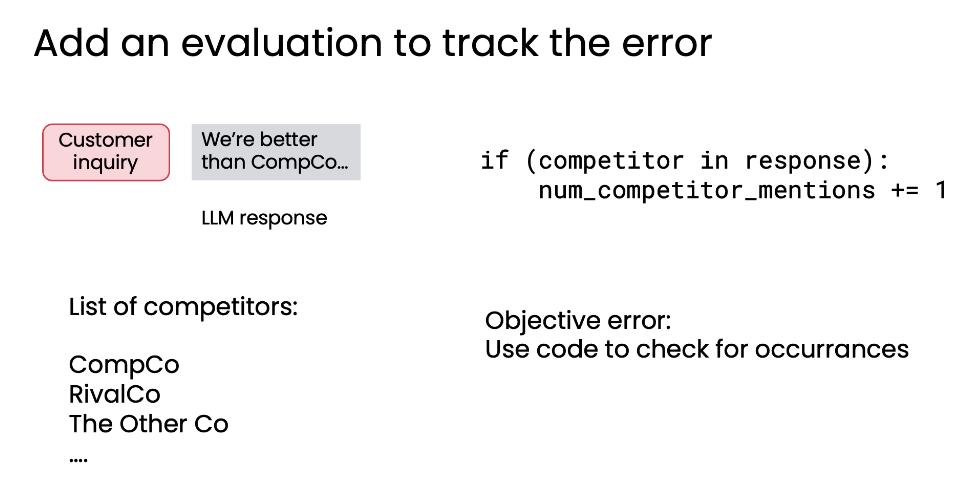
  1. 构建评估指标来追踪错误 (Add an evaluation to track the error)
  • 目标: 量化并跟踪已识别的错误。
  • 方法:
    1. 定义错误类型: 例如,“提及竞争对手”。
    2. 创建列表: 列出所有需要避免提及的竞争对手名称(如 CompCo, RivalCo)。
    3. 编写代码: 编写脚本自动扫描智能体的所有输出,统计提及这些竞争对手的次数和频率。
    • if (competitor in response): num_competitor_mentions += 1
  • 优势: 这是一个客观指标 (objective metric),可以用代码精确衡量,便于追踪改进效果。
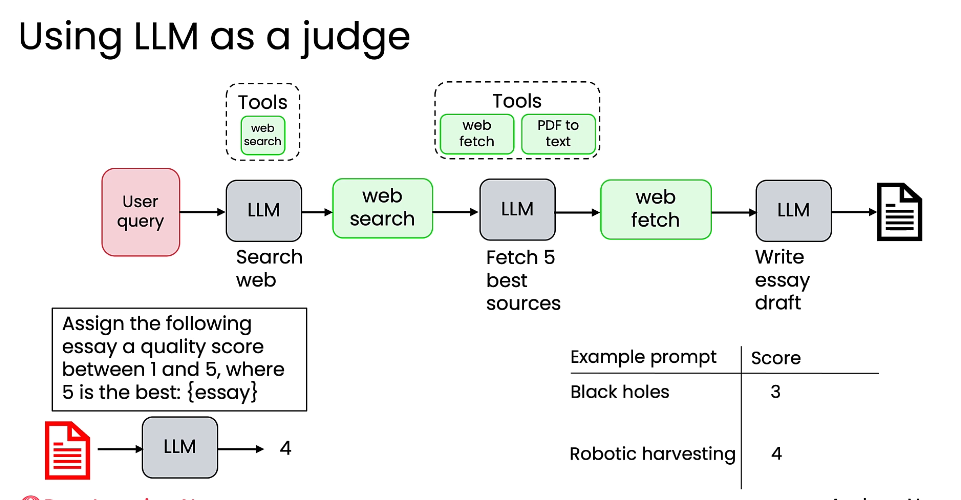
  1. 使用大型语言模型作为裁判 (Using LLM as a judge)
  • 适用场景: 当评估标准更为主观、难以用代码精确判断时(例如,评估一篇论文的质量)。
  • 方法:
    1. 构建研究代理: 例如,一个用于撰写不同主题研究报告的智能体。
    2. 引入裁判 LLM: 使用另一个 LLM 来评估第一个 LLM 生成的报告。
    3. 设计评分提示词: 让裁判 LLM 对报告进行打分(例如,1-5分,5分为最佳)。
    • 提示词示例:“请为以下文章分配一个1到5之间的质量分数,其中5是最好的:{essay}”
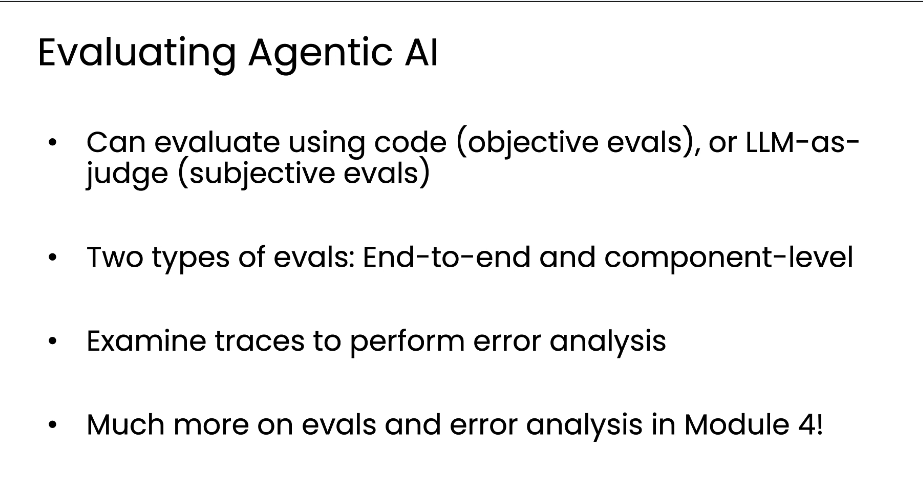
评估的两大主要类型

1、端到端评估 (End-to-end evals):衡量整个智能体最终输出的整体质量。 例如:评估一篇完整论文的最终得分。 2、组件级评估 (Component-level evals):衡量智能体工作流中单个步骤或组件的输出质量。 例如:评估第一步“提取关键信息”的准确性,或第二步“查找相关客户记录”的召回率。
最近更新: 2026/6/23 22:01
Contributors: klc407073648
Prev
为什么需要任务分解?
Next
智能体设计模式