
什么是Token
Context Window
上下文窗口:模型一次能处理的最大信息量
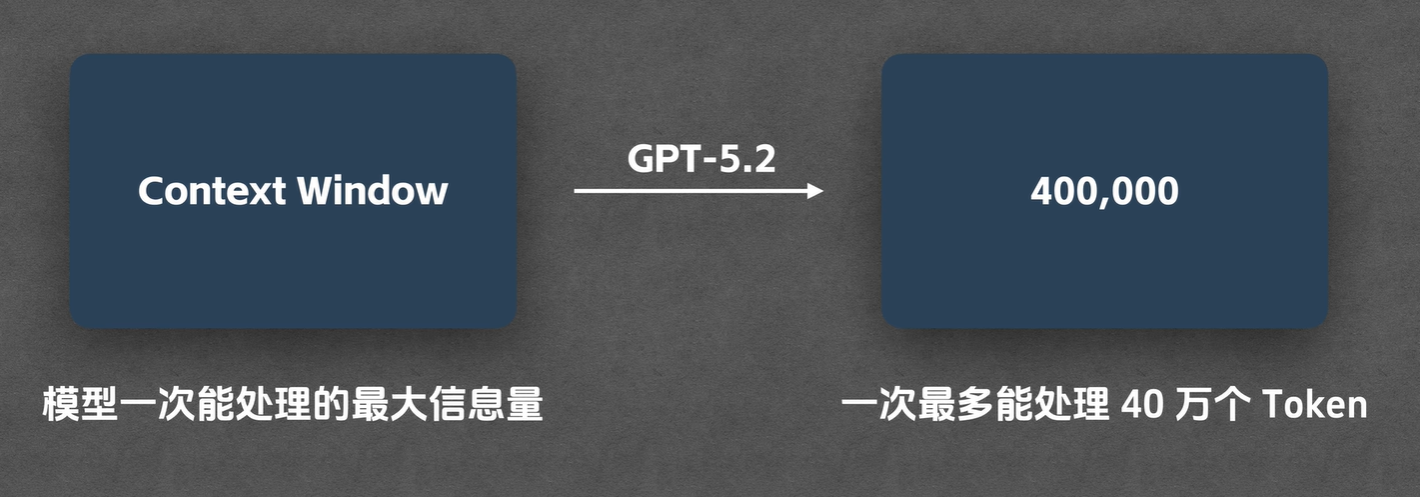
1个Token(1.5~2个汉字,4个英文字母或0.75个英文单词) 4o万 Context Window —— 60~80万个汉字或30万个英文单词
Tokenizer
要理解 Tokenizer(分词器)的实现原理,可以从两个层面来看:一是它处理文本的通用工作流程,二是其核心所采用的分词算法。简单来说,Tokenizer 是大模型与人类语言之间的“翻译官”,它的核心作用是将原始文本转换成模型能够理解和处理的数字序列。
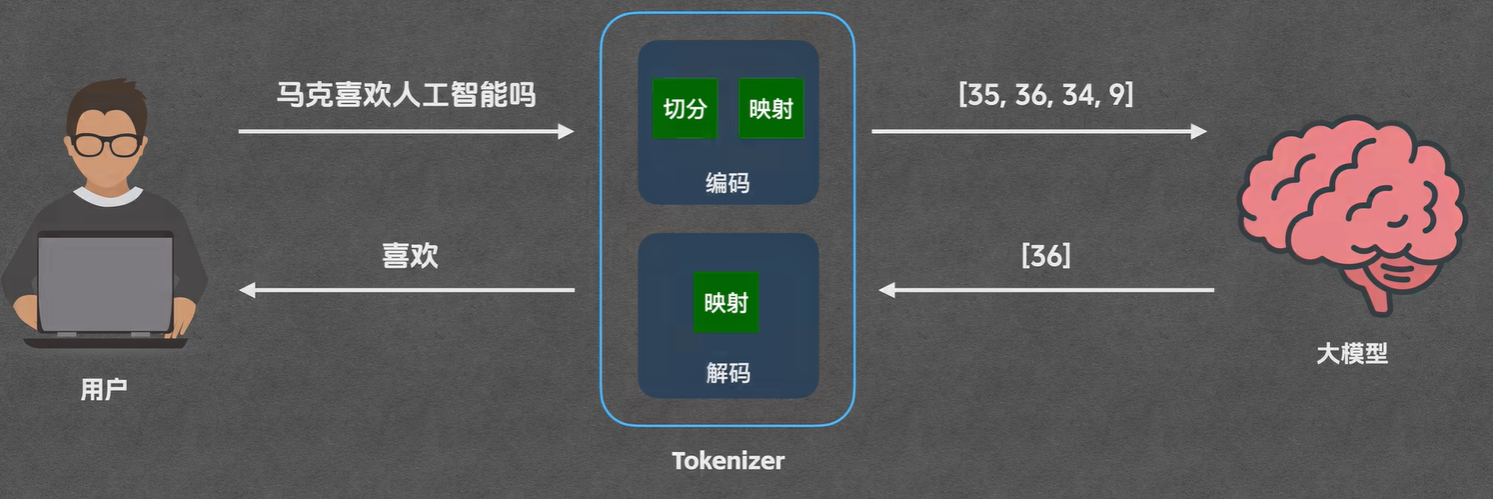
📝 Tokenizer 的通用工作流程
无论是哪种具体的算法,一个现代 Tokenizer 在处理文本时,通常会遵循一个标准化的四步流水线:
归一化 (Normalization) 这是文本预处理的第一步,目的是清洗和标准化文本。例如,将所有字符转换为小写、移除多余的空格和换行符、统一不同形式的 Unicode 字符(如将
Héllò标准化为Hello)。预分词 (Pre-tokenization) 这一步会对文本进行初步的、基于简单规则的切分。最常见的是根据空格和标点符号将句子切分成一个个独立的“词”。例如,句子 "Hello, how are you?" 会被初步切分为
['Hello', ',', 'how', 'are', 'you', '?']。模型切分 (Model) 这是 Tokenizer 最核心的一步。它会应用一个训练好的分词算法(如 BPE、WordPiece 等),将预分词后的单元进一步拆解或合并成最终的 Token。这一步决定了文本最终的切分粒度。
后处理 (Post-processing) 最后,Tokenizer 会添加一些模型所需的特殊标记。例如,在序列开头添加
[CLS]标记用于分类任务,或在句子之间添加[SEP]标记来分隔不同段落。
⚙️ 核心的分词算法
目前主流大模型几乎都采用子词级别 (Subword-level) 的分词方法,因为它在“词级别”(词汇表过大,无法处理生僻词)和“字符级别”(序列过长,语义信息弱)之间取得了最佳平衡。以下是三种最主流的子词分词算法:
BPE (Byte Pair Encoding, 字节对编码)
这是目前应用最广泛的算法,被 GPT、LLaMA、RoBERTa 等模型采用。
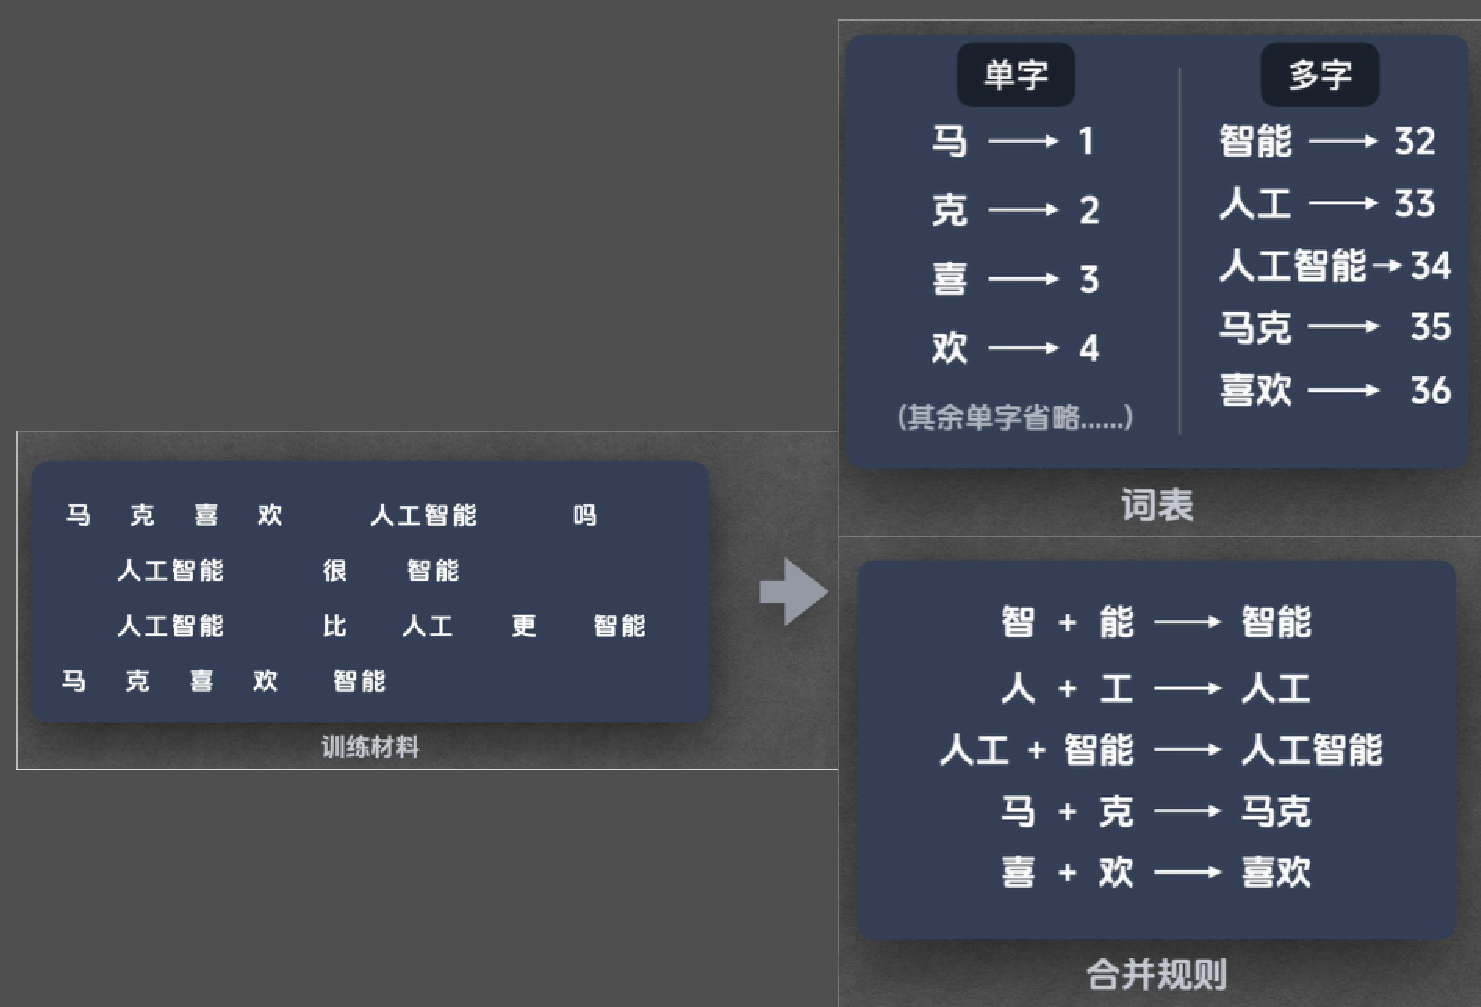
- 核心思想:从字符级别开始,通过统计海量语料中相邻字符对的出现频率,反复合并最高频的字符对,逐步构建一个固定大小的词汇表。
- 工作原理:
- 训练阶段:从所有字符组成的词汇表开始,迭代地统计并合并出现频率最高的相邻符号对(例如,
e和s经常一起出现,就合并成es),直到词汇表达到预设的大小。 - 推理阶段:将新文本先切分成字符,然后应用训练阶段学到的合并规则,将其组合成最终的 Token。
- 训练阶段:从所有字符组成的词汇表开始,迭代地统计并合并出现频率最高的相邻符号对(例如,
- 例子:对于单词 "unhappiness",BPE 可能会将其切分为
['un', 'happy', 'ness']。
WordPiece
这是 Google 为 BERT 模型开发的算法。
- 核心思想:与 BPE 类似,但合并规则的选择标准不同。WordPiece 使用一种基于似然估计的准则,选择能最大化训练数据似然概率的子词进行合并。
- 特点:它有一个显著的标志,即用
##前缀来表示一个 Token 是前一个 Token 的延续。 - 例子:单词 "playing" 可能会被切分为
['play', '##ing']。
SentencePiece
这是一种更通用的实现,被 T5、mT5 等模型使用。
- 核心思想:它将输入文本视为一个连续的 Unicode 字符流,不依赖于空格进行预分词。它通常将空格本身也作为一个特殊符号(如
▁)来处理。 - 优势:这种设计使其天生对中文、日文等没有显式空格分隔的语言非常友好,实现了语言无关性。
Unigram
Unigram 是一种与 BPE、WordPiece 截然不同的子词分词算法。如果说 BPE 和 WordPiece 是“从小到大”的合并式算法,那么 Unigram 就是“从大到小”的剪枝式算法。它被 T5、ALBERT、mBART 等模型采用,并通常通过 SentencePiece 库来实现。
核心思想:反向剪枝与概率模型
- Unigram 的核心思想是:从一个包含大量候选子词(如所有高频子串)的巨大词汇表开始,然后通过迭代删除对模型“贡献”最小的子词,逐步将词汇表缩小到目标大小。
- 这里的“贡献”是基于一个概率模型来衡量的。Unigram 模型假设一个文本序列中每个子词的出现都是相互独立的,因此整个文本的概率就是其中所有子词概率的乘积。
- 例如,对于文本 "apple",如果拆分为
["app", "le"],其概率为P(app) × P(le);如果拆分为["a", "pp", "le"],其概率为P(a) × P(pp) × P(le)。Unigram 的目标是保留那些能让整个训练语料库概率(即似然)最大的子词。
工作原理:EM 算法迭代优化
Unigram 的训练过程通常使用期望最大化(EM)算法,交替执行以下两个步骤,直到词汇表达到预设大小:
1.E 步 (Expectation Step): 计算概率
在当前词汇表下,使用 Viterbi 算法(一种动态规划算法)为训练语料中的每个词找到概率最高的切分方式。
统计每个子词在所有最优切分中出现的总次数,并据此计算其在当前词表下的概率。
2.M 步 (Maximization Step): 剪枝
评估词汇表中每个子词的“重要性”。具体做法是计算如果移除该子词,整个语料库的似然会下降多少(即损失值)。
删除那些对整体似然影响最小(即损失值最低)的 10%~20% 的子词。
为了保证任何文本都能被编码,单字符(如 'a', 'b', 'c')会永远保留在词汇表中,不会被删除。
分词逻辑:全局最优而非贪心
Unigram 在分词时,不像 BPE 那样按固定顺序进行贪心匹配,而是利用训练好的概率模型,为新的文本寻找全局概率最高的切分方式。
例如,对于一个训练好的 Unigram 分词器,词汇表中有
["h", "u", "g", "s", "hug", "ugs"]。当处理新词 "hugs" 时,它可能会产生多种切分可能,如["hug", "s"]或["h", "ugs"]。Unigram 会计算每种切分的概率:P(["hug", "s"]) = P(hug) × P(s)P(["h", "ugs"]) = P(h) × P(ugs)
最终,它会选择概率值更高的那一种作为最终结果。