大模型流程
大语言模型(LLM)生成文本的核心逻辑:
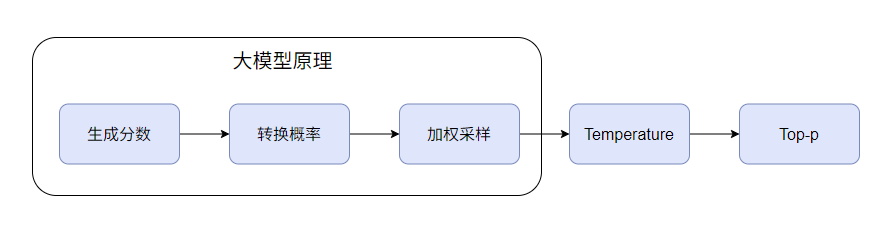
大模型生成文本的**“预测-调整-选择”**循环:
- 生成分数:计算每个词有多合适。
- 转换概率:把合适程度变成百分比。
- 加权采样:根据百分比抽奖选词。
- Temperature & Top-p:这两个参数用来控制“怎么抽”——是稳妥地抽(低温度、低Top-p),还是大胆地抽(高温度、高Top-p)。
这个过程会不断循环,一个字接一个字,直到生成完整的句子或段落。
生成分数
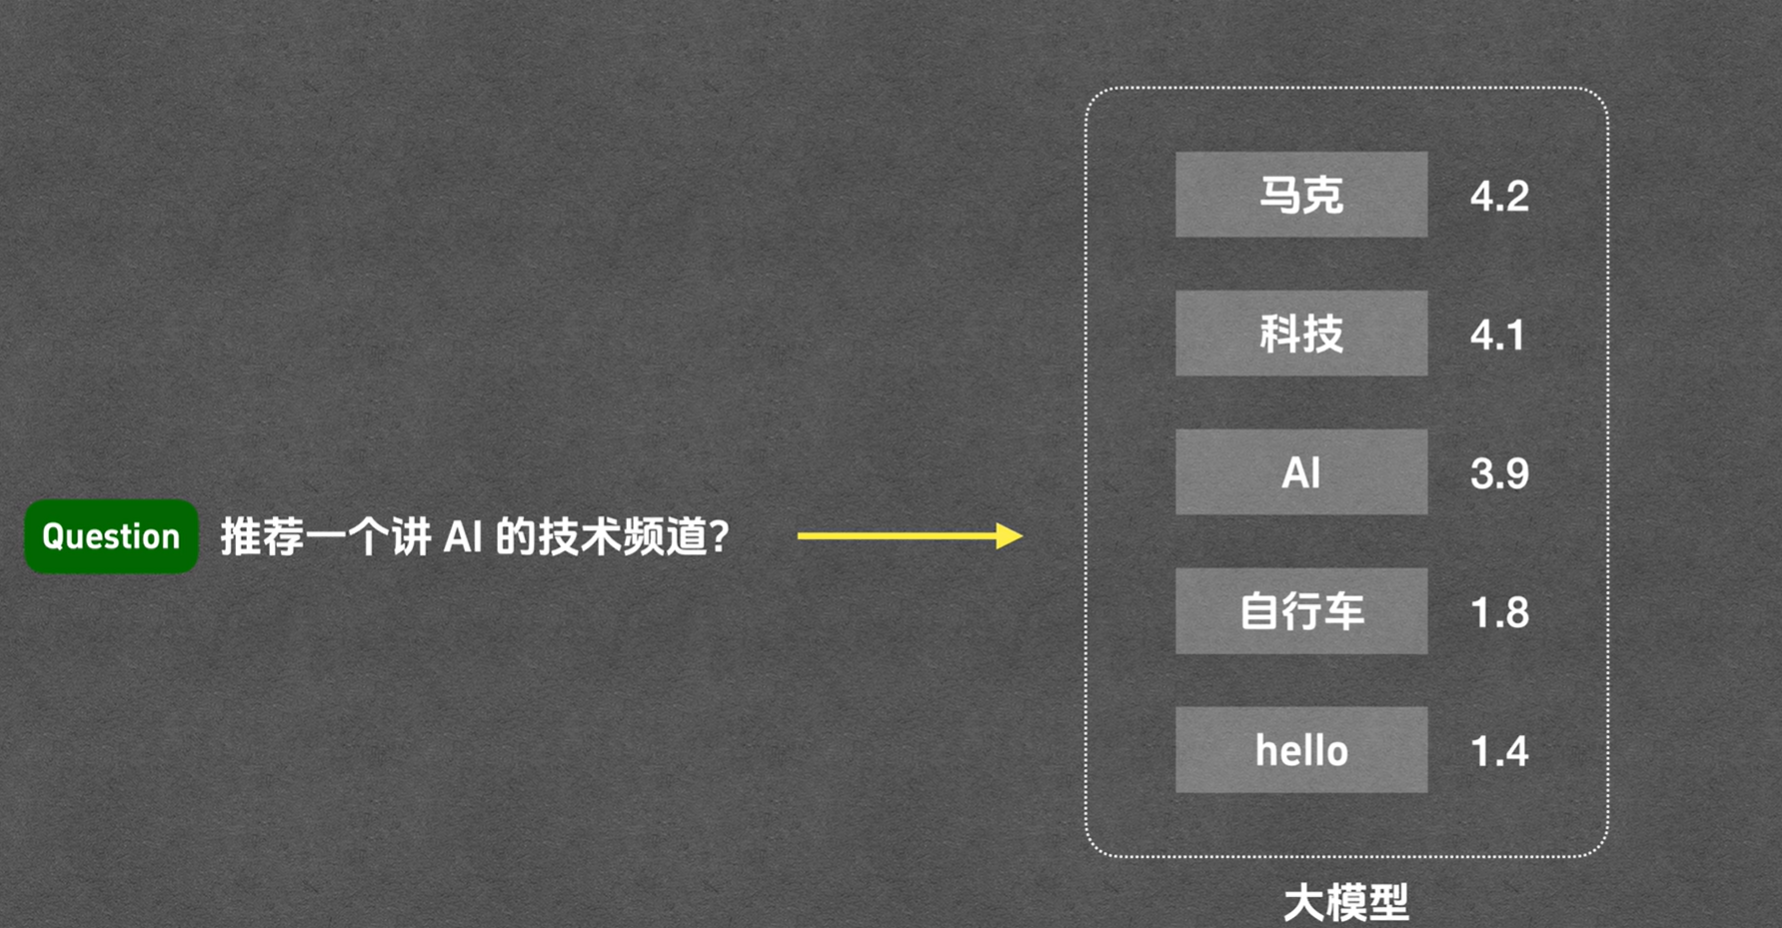
大语言模型(LLM)生成“分数”的过程,也就是计算 Logits 的过程。简单来说,Logits 是模型对词表中每一个词成为“下一个词”的可能性的原始打分。
以下是 Logits 生成的详细过程与原理拆解:
核心原理:从“语义向量”到“词汇打分”
在计算 Logits 之前,模型已经通过多层 Transformer 结构对输入的上下文进行了深度的处理,最终得到了一个包含丰富上下文信息的高维向量(通常称为隐藏状态,Hidden State)。
Logits 的生成,本质上是一个线性变换的过程,你可以把它想象成一个“翻译”或“映射”的步骤:
- 输入: 模型输出的最后一个高维向量(代表了对当前语境的理解)。
- 变换矩阵: 这是一个巨大的参数矩阵(通常称为 Unembedding Matrix 或 LM Head)。这个矩阵的大小通常是
[隐藏层维度 × 词表大小]。- 例如,如果隐藏层维度是 4096,词表有 32,000 个词,这个矩阵就有 4096 × 32,000 个参数。
- 这个矩阵中的每一列,实际上对应着词表中某一个特定词的“特征向量”。
- 计算(矩阵乘法): 模型将“上下文向量”与这个巨大的“变换矩阵”相乘(点积)。
- 原理: 点积运算本质上是在计算相似度。如果“上下文向量”与词表中某个词(比如“猫”)的向量方向非常接近(相似度高),计算出的数值就会很大;反之则很小。
结果: 经过这次乘法运算,模型得到了一个长度为 词表大小 的向量,这个向量里的每一个数值,就是对应那个词的 Logit。
打分示例:
转换概率
将模型计算出的原始分数(Logits,数值范围无限,可正可负)转化为人类可理解的概率分布(Probabilities,数值在 0 到 1 之间,且总和为 1)。
这一转换的数学工具就是大名鼎鼎的 Softmax 函数。
以下是这一过程的详细拆解:
Softmax 工作原理
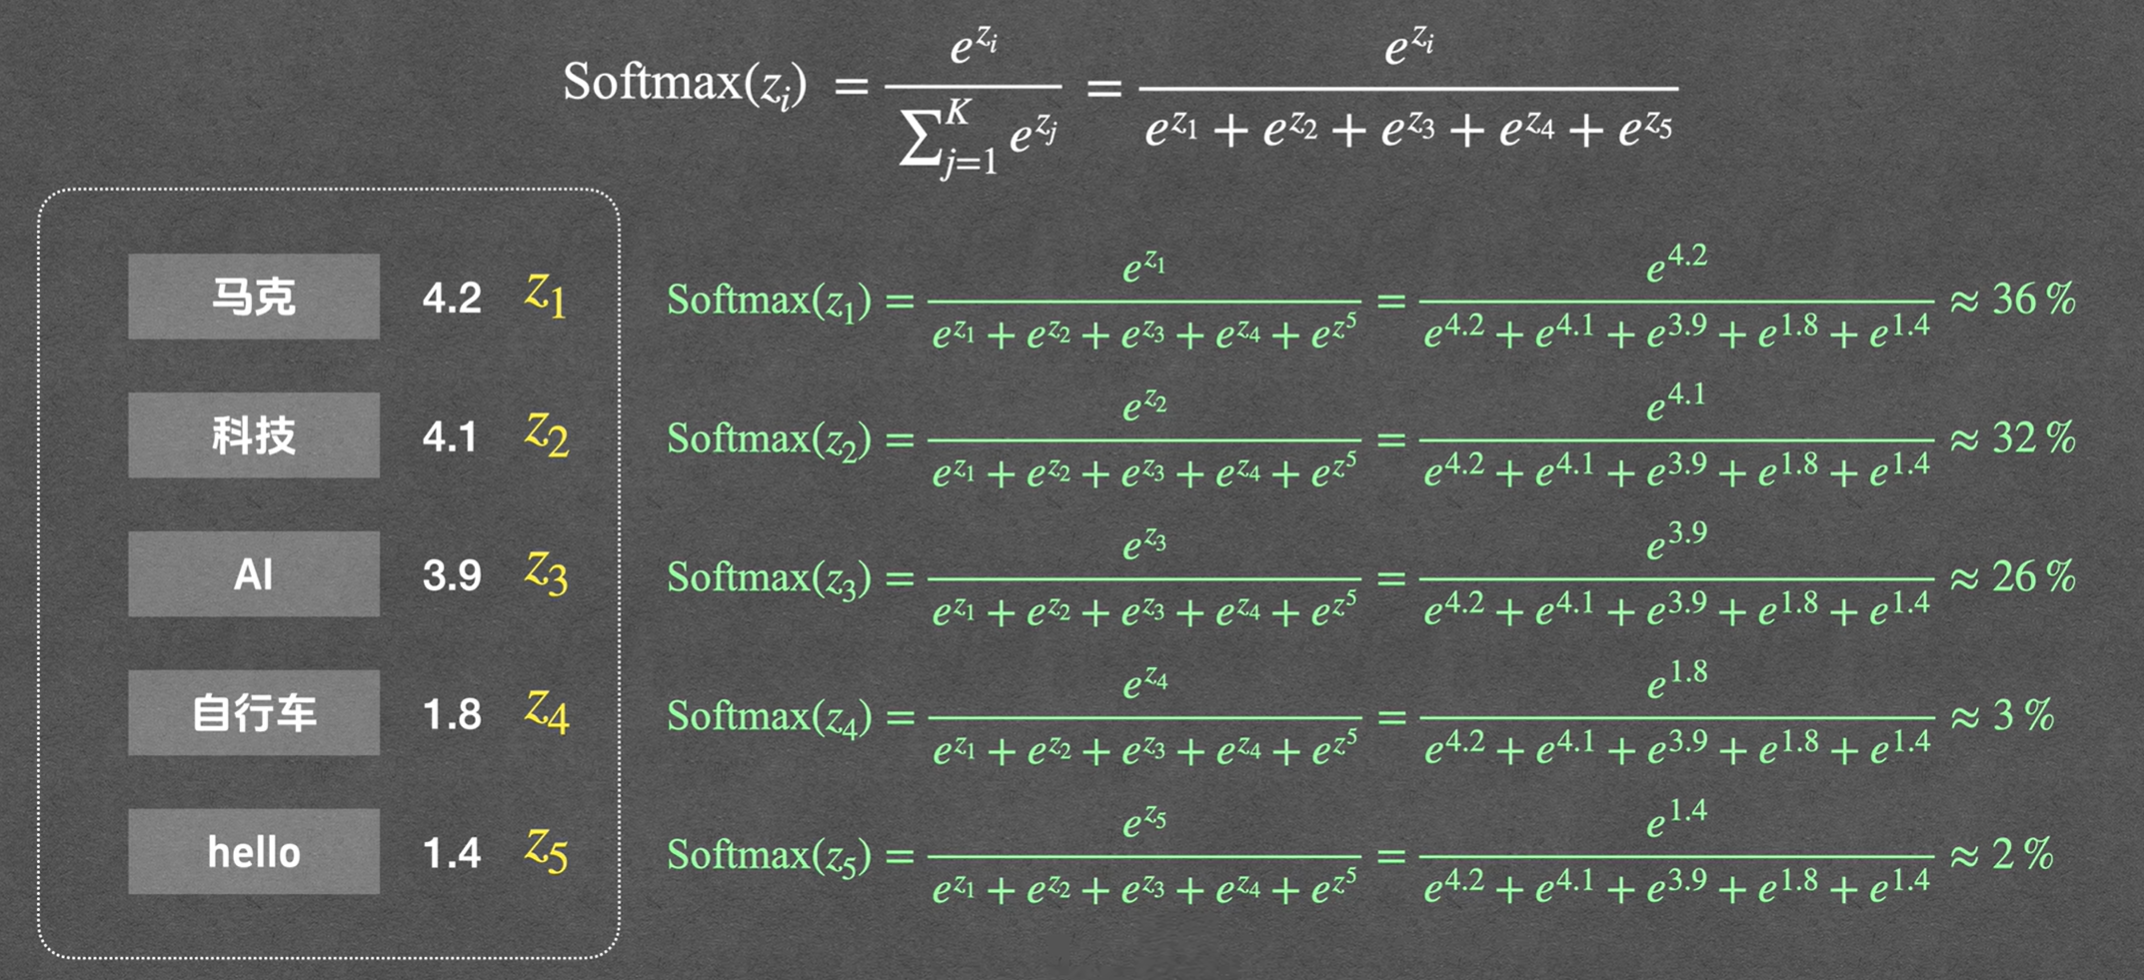
Softmax 函数的数学表达式如下(加入了温度参数 的通用形式):
其中:
- :第 个词的 Logit(原始分数)。
- :第 个词被选中的 概率。
- :自然常数(约等于 2.718)。
- :温度(Temperature),用于调节随机性(默认为 1)。
- :词表的总大小。
举例说明
左边是原始的Logit(原始分数),右侧是经过Softmax公式转换得到的下一个词的概率
加权采样
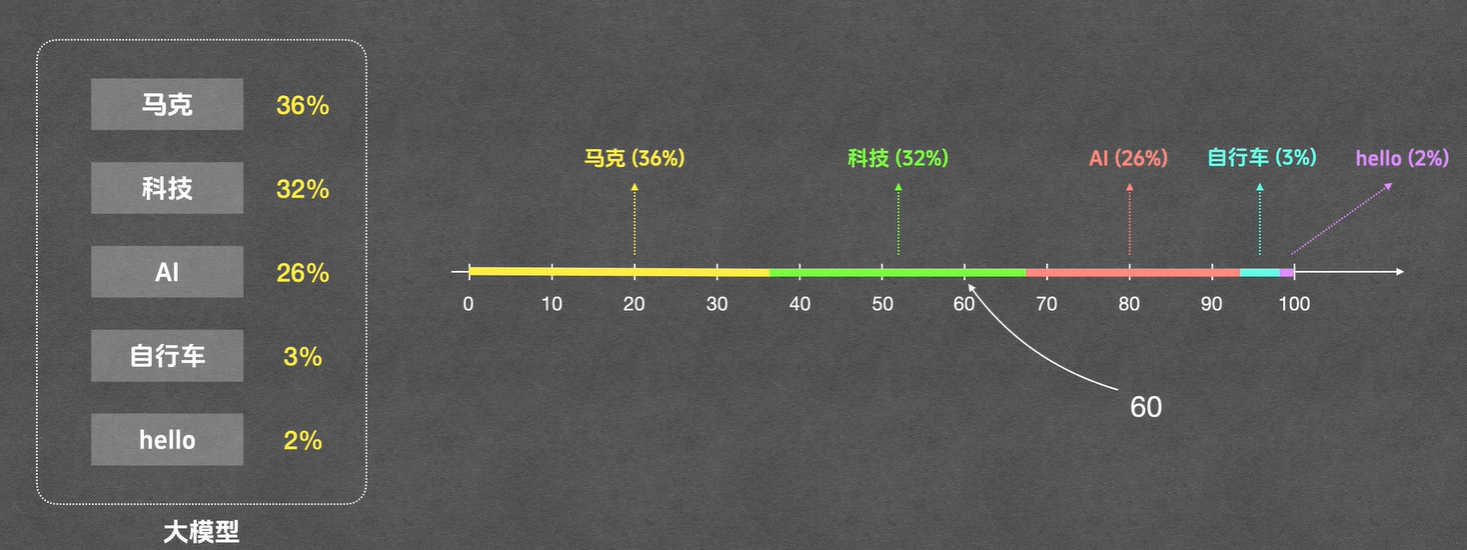
如果每次都只选概率最高的词,模型很容易陷入死循环,比如不断重复“人工智能的未来是非常重要的,因为人工智能的未来是非常重要的……”。加权采样通过引入随机性,让模型有机会跳出这个循环。即加权采样就是给模型一个“有偏向的骰子”,让它在生成下一个词时,既遵循大概率,又保留小概率的惊喜。
具体实现:
通过生成0-100的随机数,当对应值落在数轴上对应区域时,则选择对应词作为下一个预测词。
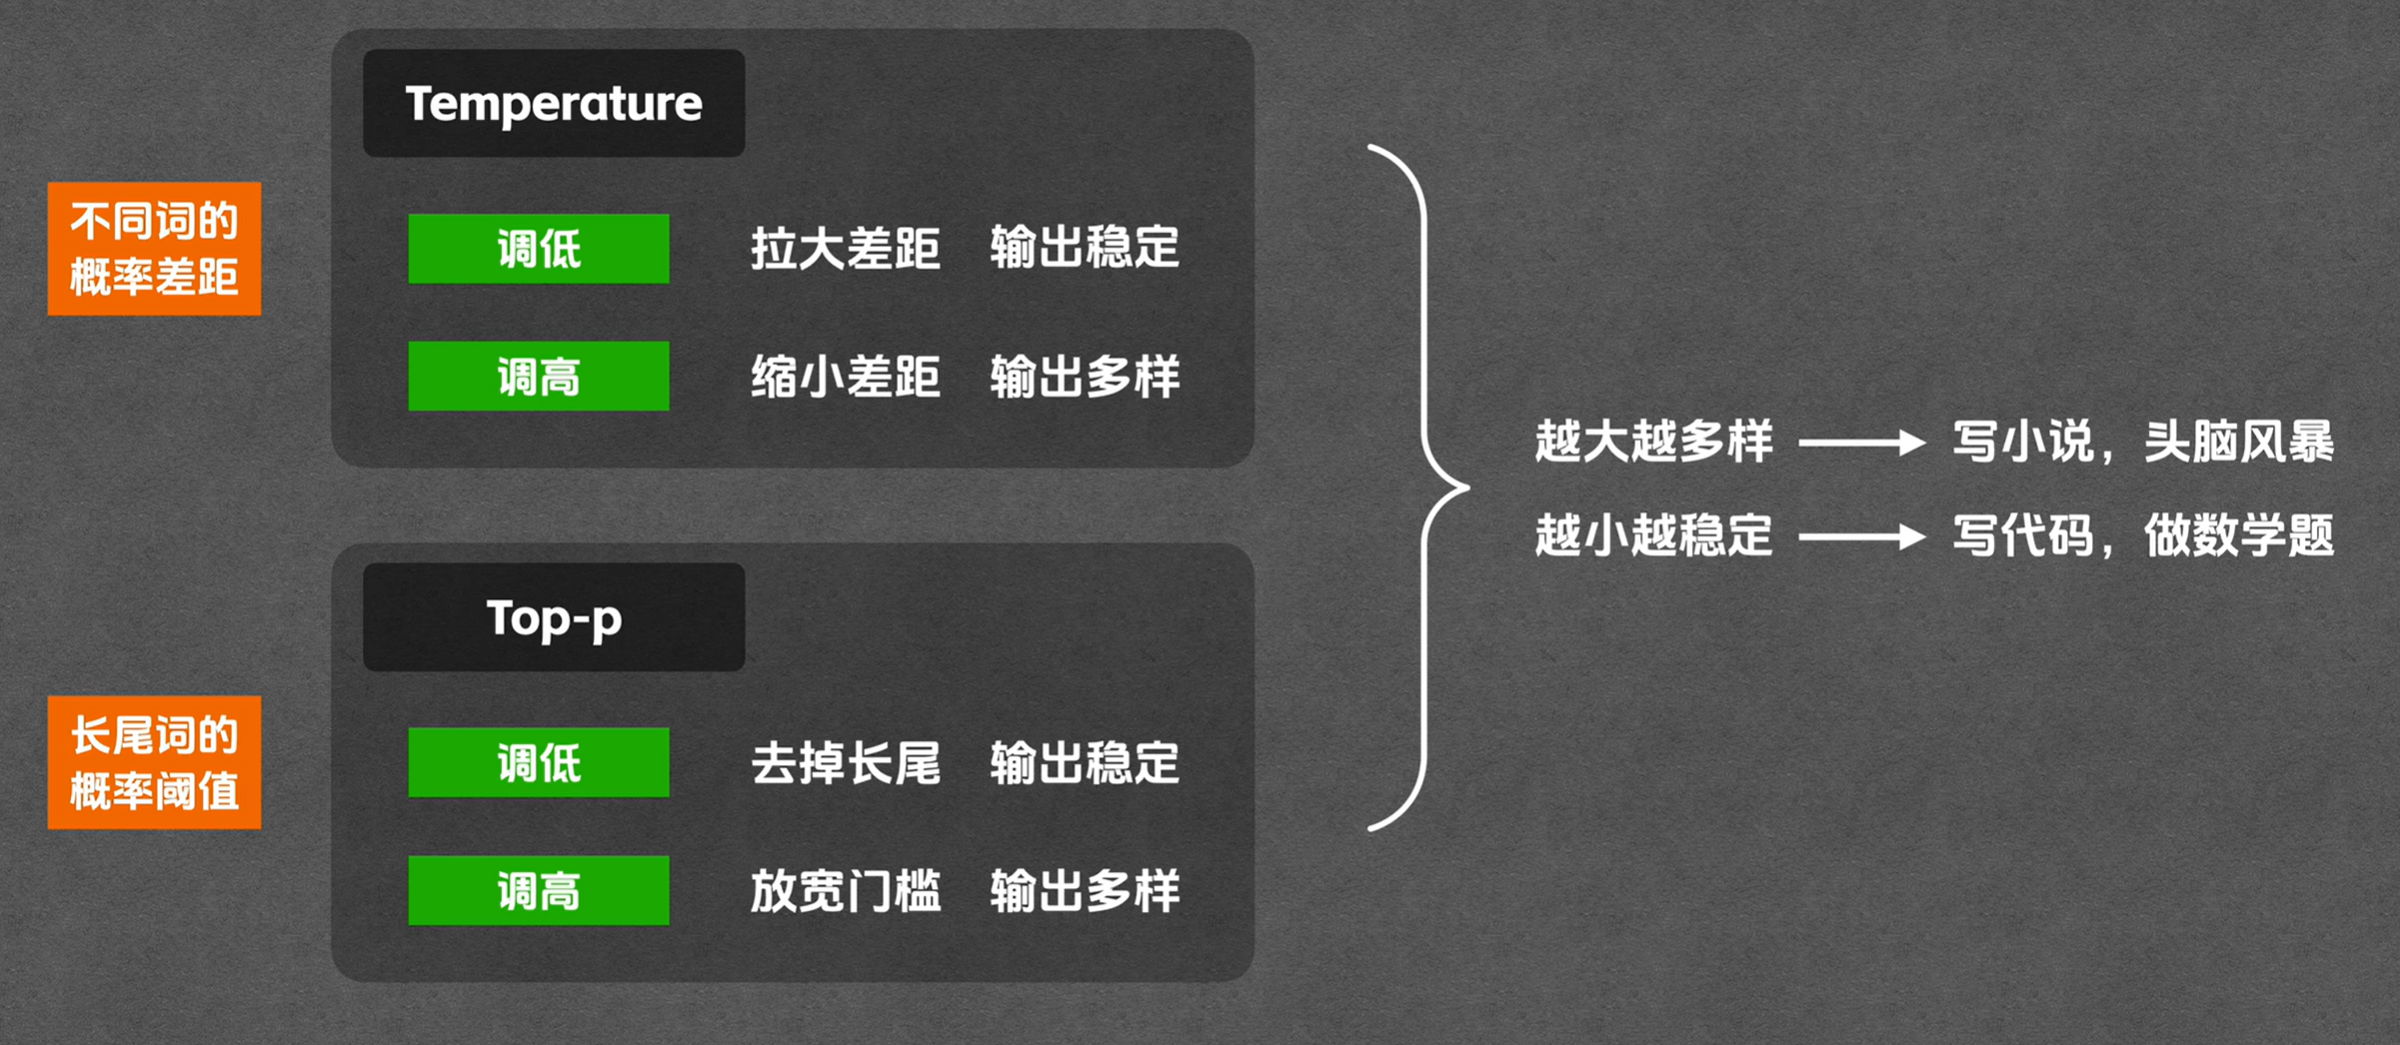
Temperature作用
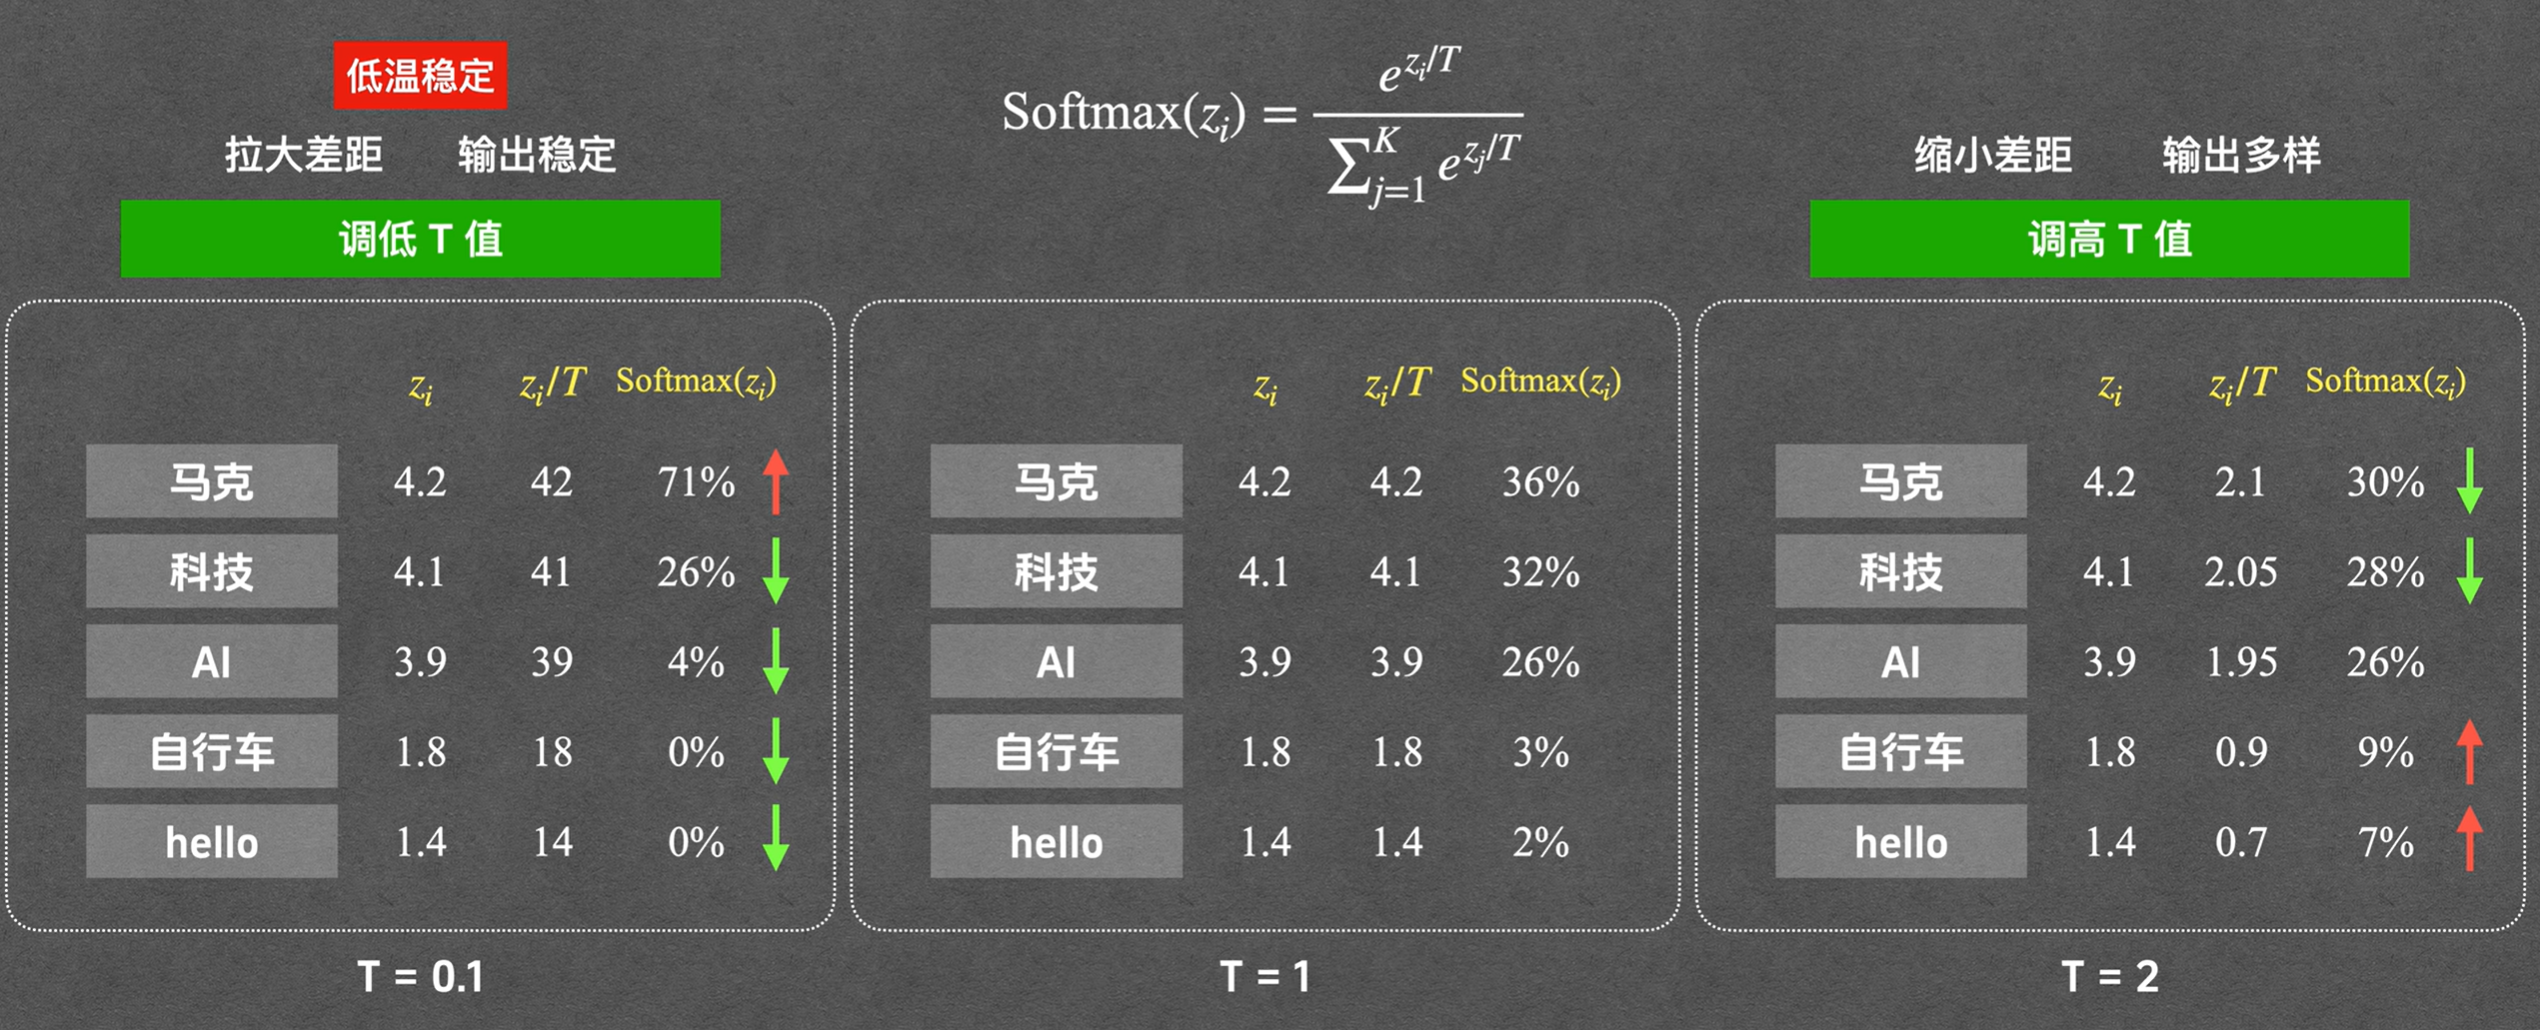
在 Softmax 公式中,温度 T 是一个除数,它决定了概率分布的“形状”。
- 低温度( T<1 ):让分布变“尖锐”
- 原理:当 T 很小时,Logits 除以 T 会变得很大。经过指数运算后,原本分数最高的词的概率会无限接近 1,而其他词的概率会趋近于 0。
- 效果:模型变得非常保守和确定,几乎总是选择得分最高的词(类似“贪婪解码”)。
- 高温度( T>1 ):让分布变“平坦”
- 原理:当 T 很大时,Logits 除以 T 会变得很小(趋近于 0)。 e^0=1 ,这意味着所有词的指数分数都变得差不多,最终概率也趋于平均。
- 效果:模型变得随机和发散,低分词也有很大机会被选中,增加了创造性,但也可能导致胡言乱语。
Top-p作用
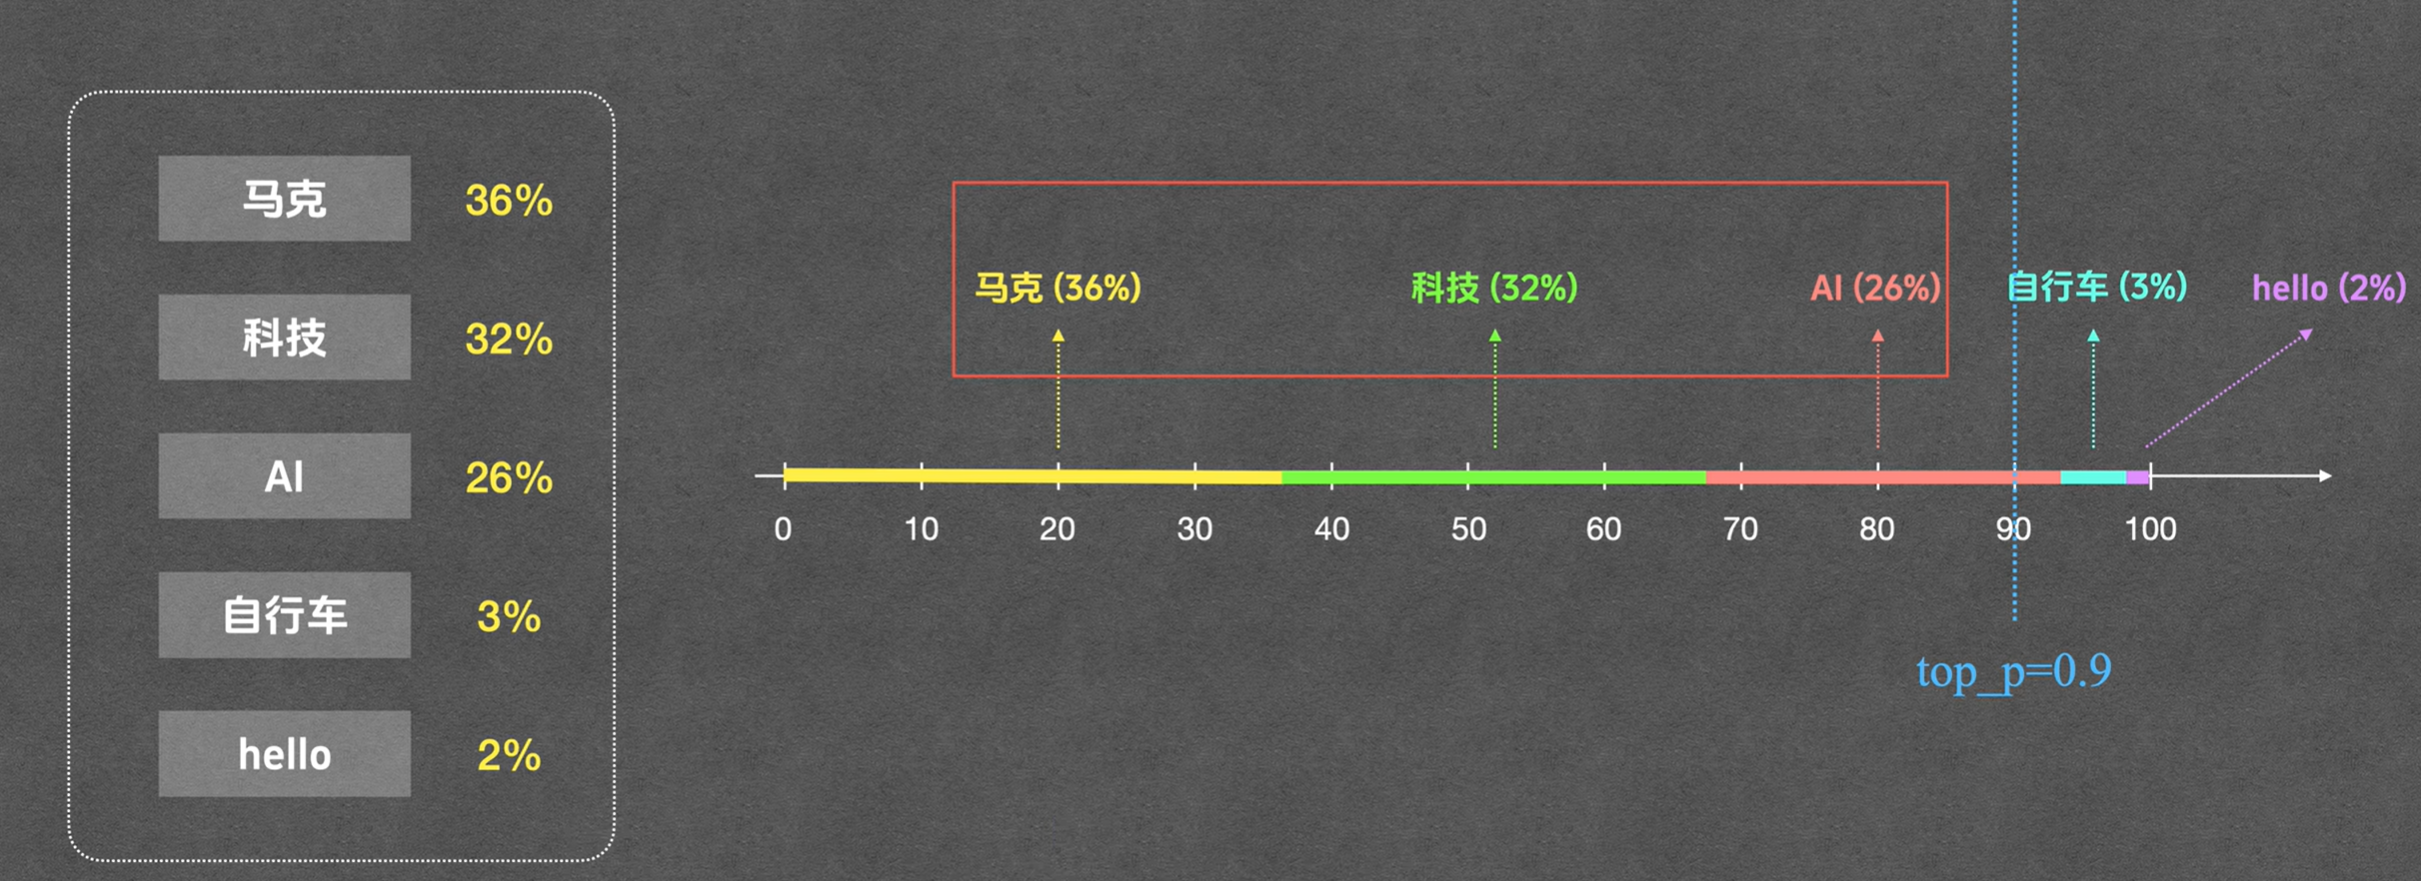
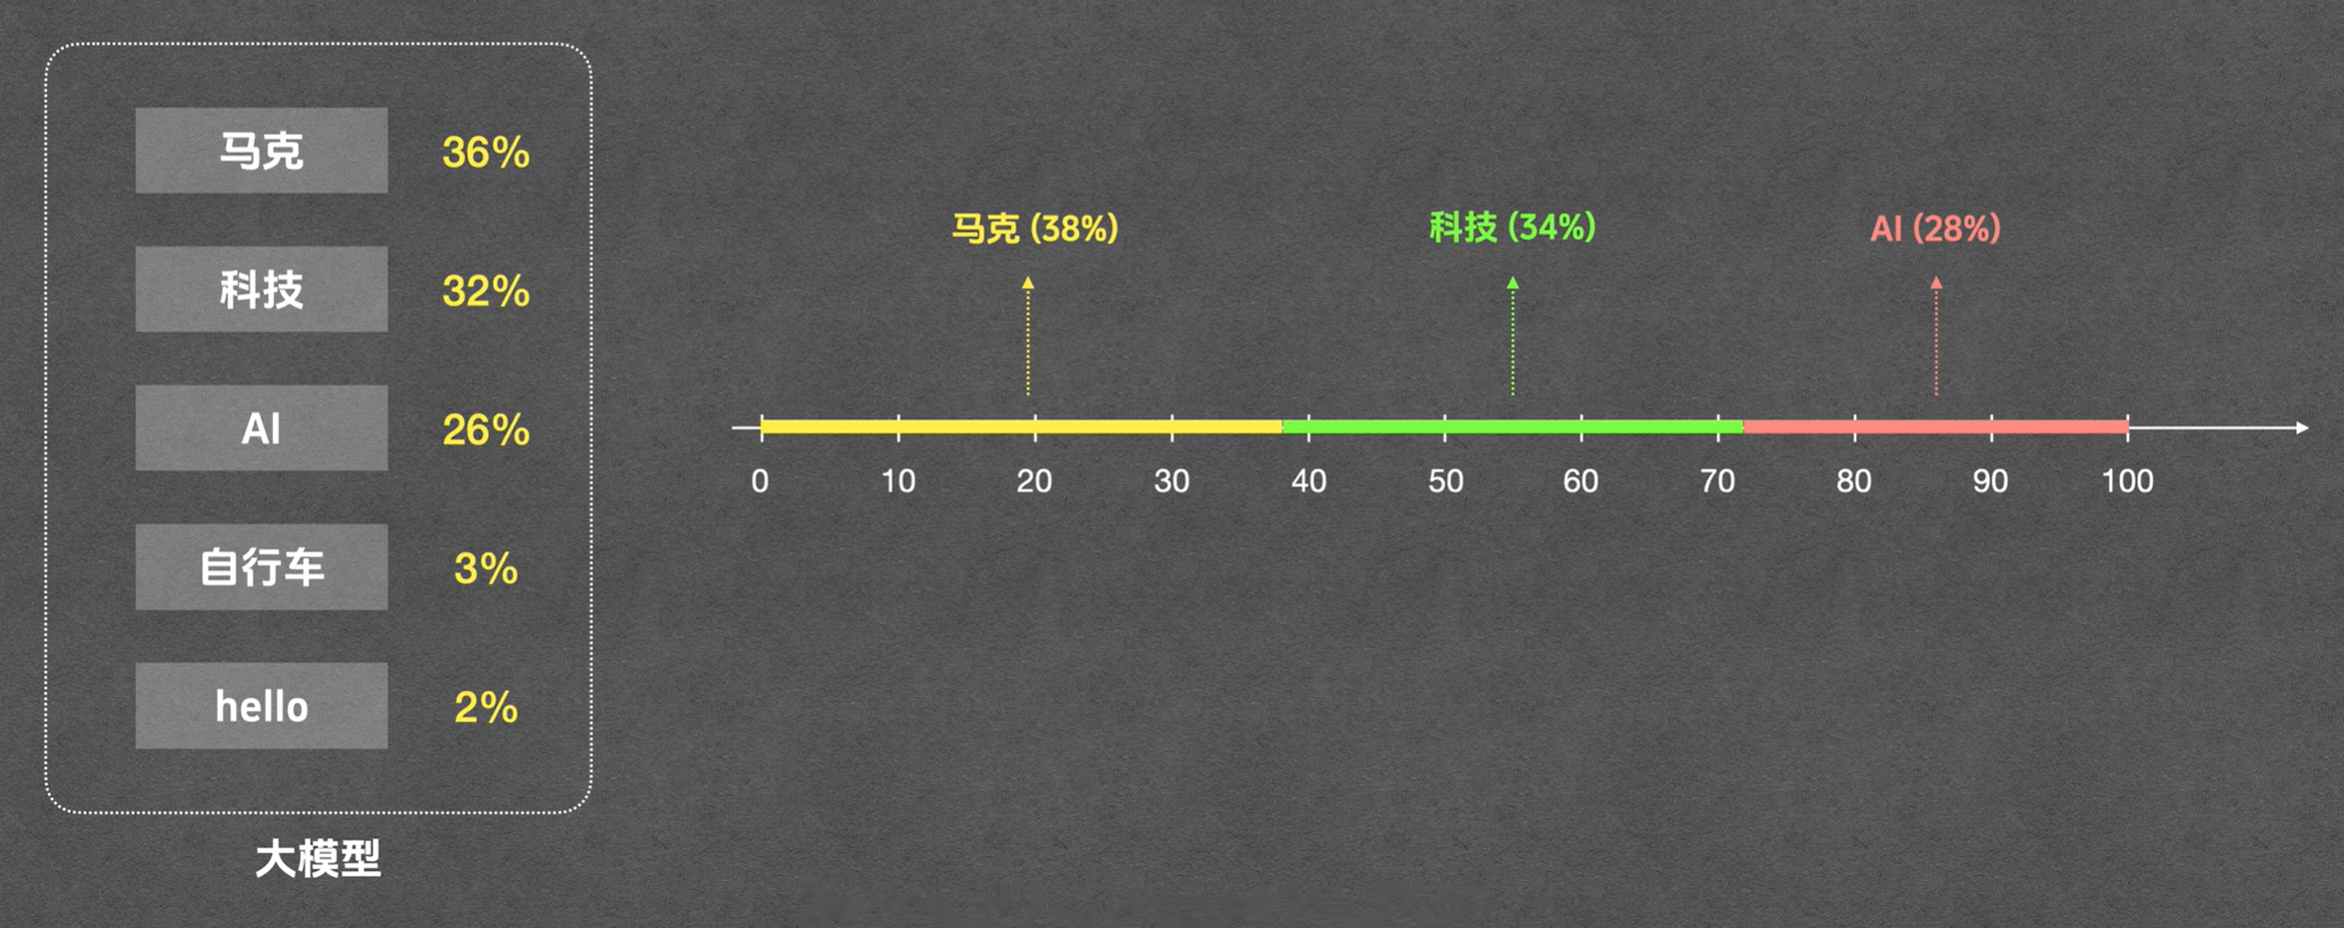
设定一个累积概率阈值 p(比如 0.9)。模型会将候选词按概率从高到低排序,然后从第一名开始累加概率,直到总和刚好达到或超过 p 为止。所有被累加过的词构成最终的候选池。(对应概率被同比例放大)
Top-p 确保了候选池里的词代表了绝大部分的可能性,从而有效过滤掉那些概率极低、质量很差的“垃圾词”,避免了胡言乱语。同时,它又在高质量词池中保留了随机性,让输出不至于单调乏味。
同比例放大:
总结
Temperature和Top-p作用: