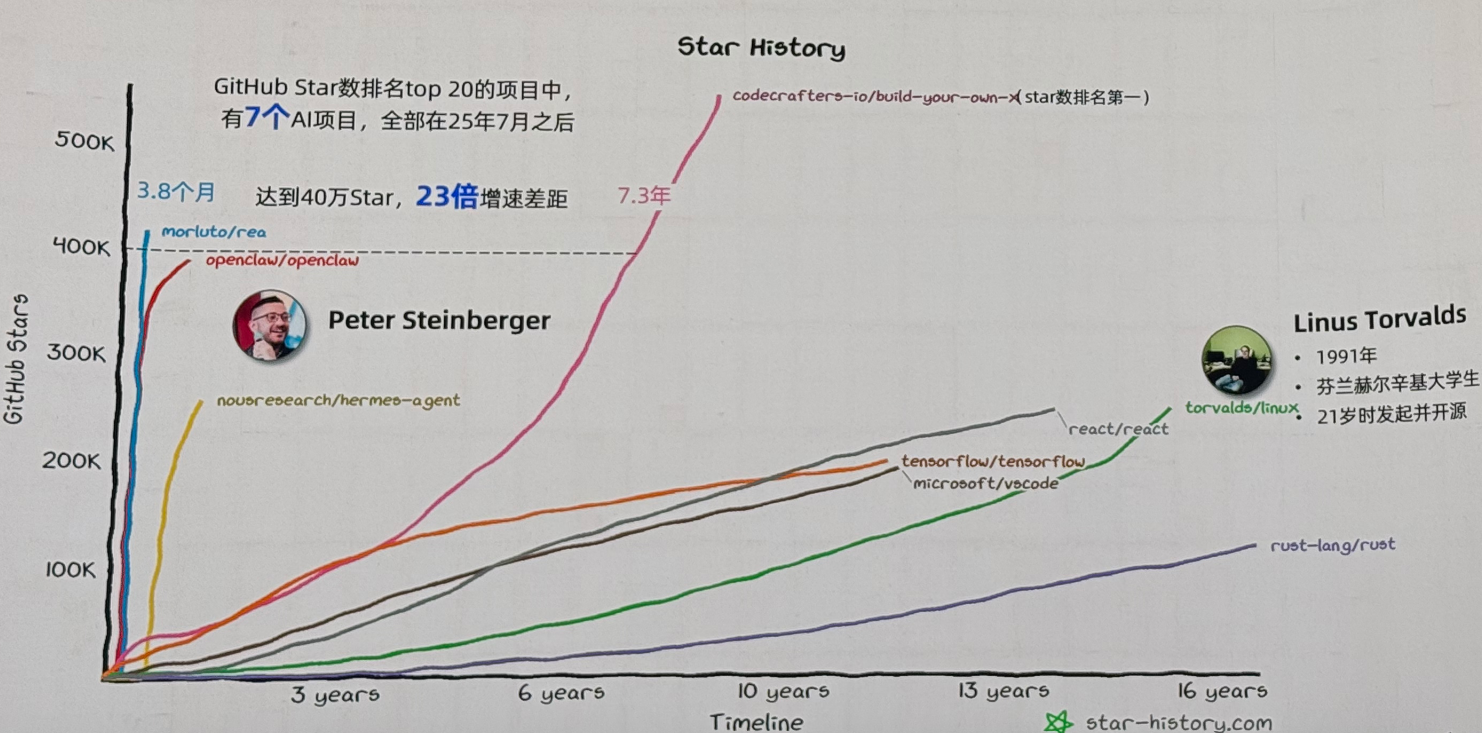
为什么人工智能超越了计算机革命、互联网革命?
在人类迈向数字世界的征途中,开源一直是技术进步的强大引擎
软件开源 vs模型开源
| 对比维度 | 软件开源 (Traditional Open Source) | AI / 模型开源 (AI / Model Open Source) |
|---|---|---|
| 核心本质 | • 利他主义与技术共享的精神 • 通过开放核心成果打破垄断,促进全球协同创新 | (同左,为两者共同核心) |
| 生态模式 | • 高度依赖社区化运营,生命力均取决于社区活跃度、开发者反馈及衍生生态的繁荣 | (同左,为两者共同特征) |
| 合规诉求 | • 均需通过开源许可证约束边界(如 Apache 2.0 / MIT协议等) | (同左,为两者共同要求) |
| 核心开源内容 | • 软件源代码为主:包括源文件、编译器、构建脚本、二进制文件、配置文件及传统开源许可证 • 显性逻辑,可见、可理解、逻辑清晰 | • 模型权重为主:包括网络架构(代码)、各类组件(算法)、训练/评测数据集以及前向推理部署工具 • 隐形黑盒,不可解释、统计概率 |
| 部署与二次开发门槛 | • 低硬件依赖:普通电脑即可编译和运行。部署及二次开发门槛较低,主要消耗开发者的“智力与时间” | • 高算力依赖:部署与运行极度依赖 GPU/NPU。模型参数量越大,对硬件配置、显存及运行环境的要求呈指数级上升 |
| 开发成本与社会化分摊 | • 群体智慧摊薄成本:依赖分布式开发者共同参与贡献,通过社会化协同,能有效摊薄软件的研发、修包与维护成本 | • 资本密集型(巨头承载):基座模型预训练成本极高(千万级算力与数据投入),开源无法摊薄高昂的预训练沉没成本 • 社区主要承接微调和应用 |
| 开发者对社区的贡献形式 | • 代码级贡献:提交代码补丁(PR)、修复系统 Bug、编写技术文档、在 Issue 中提出新功能建议 | • 衍生与数据反馈:发布微调衍生模型(如 LoRA/Adapter)、贡献高质量行业数据集、反馈人类偏好数据(RLHF/RLAIF) |
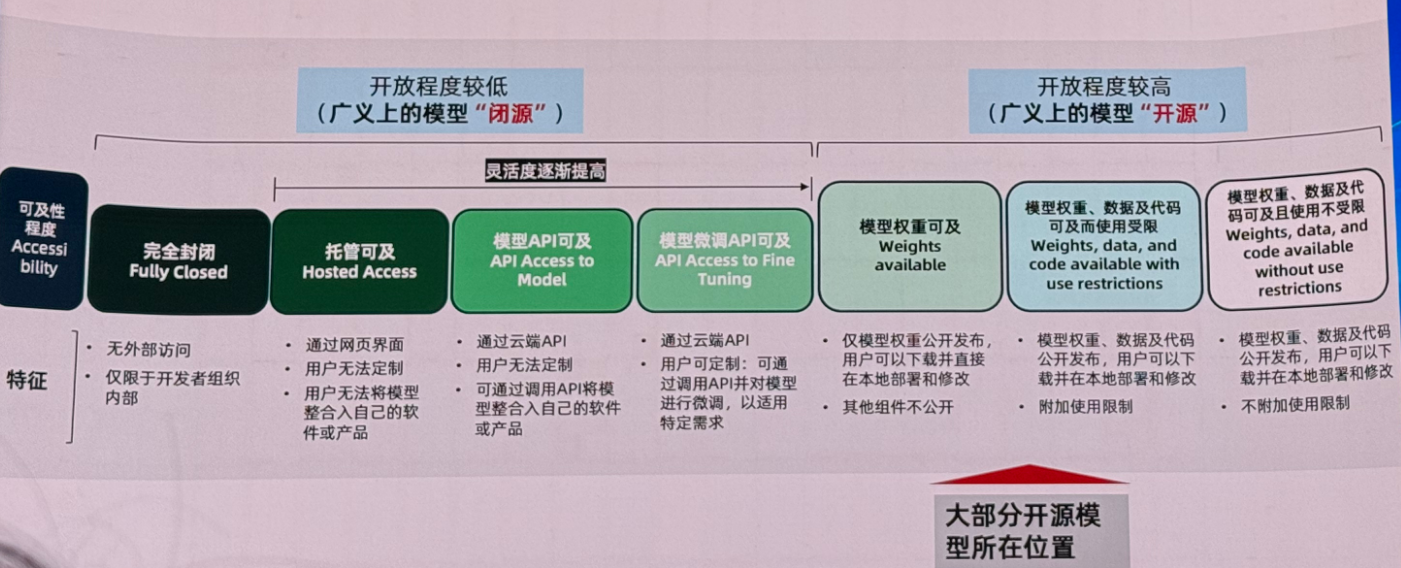
什么是模型开源?
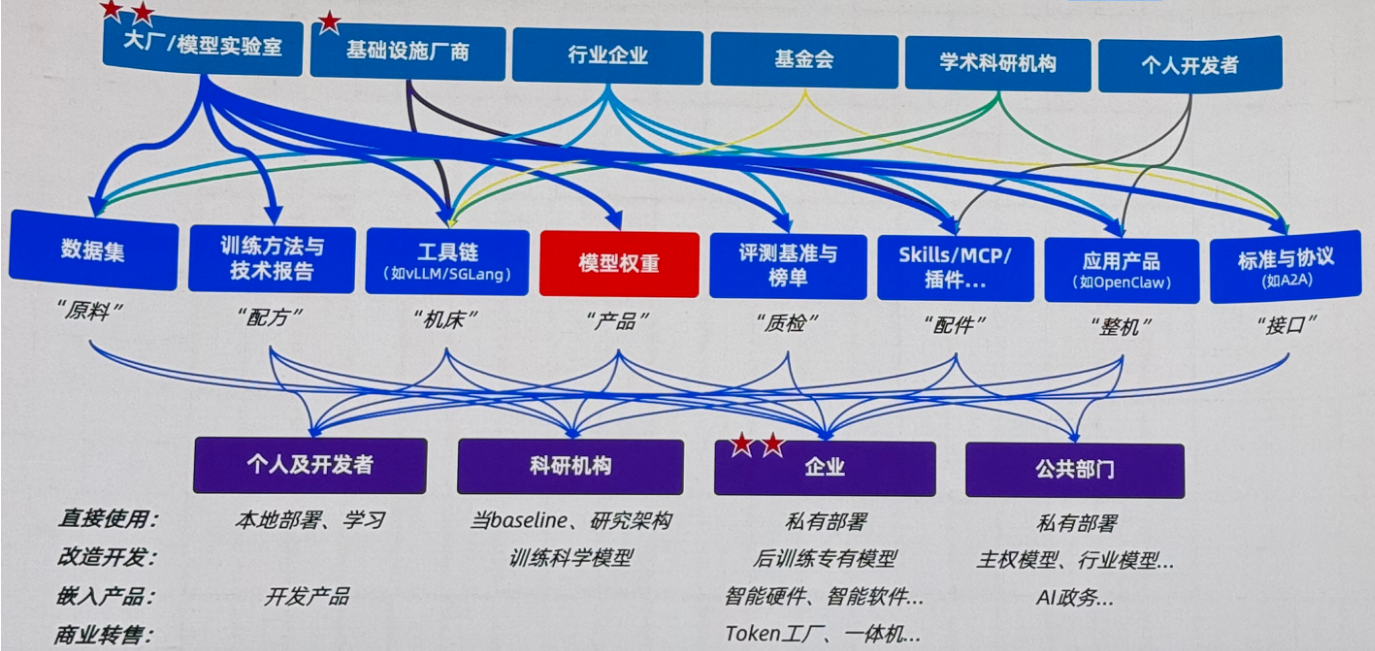
AI时代的开源生态全景图:谁在贡献?贡献什么?谁在使用?
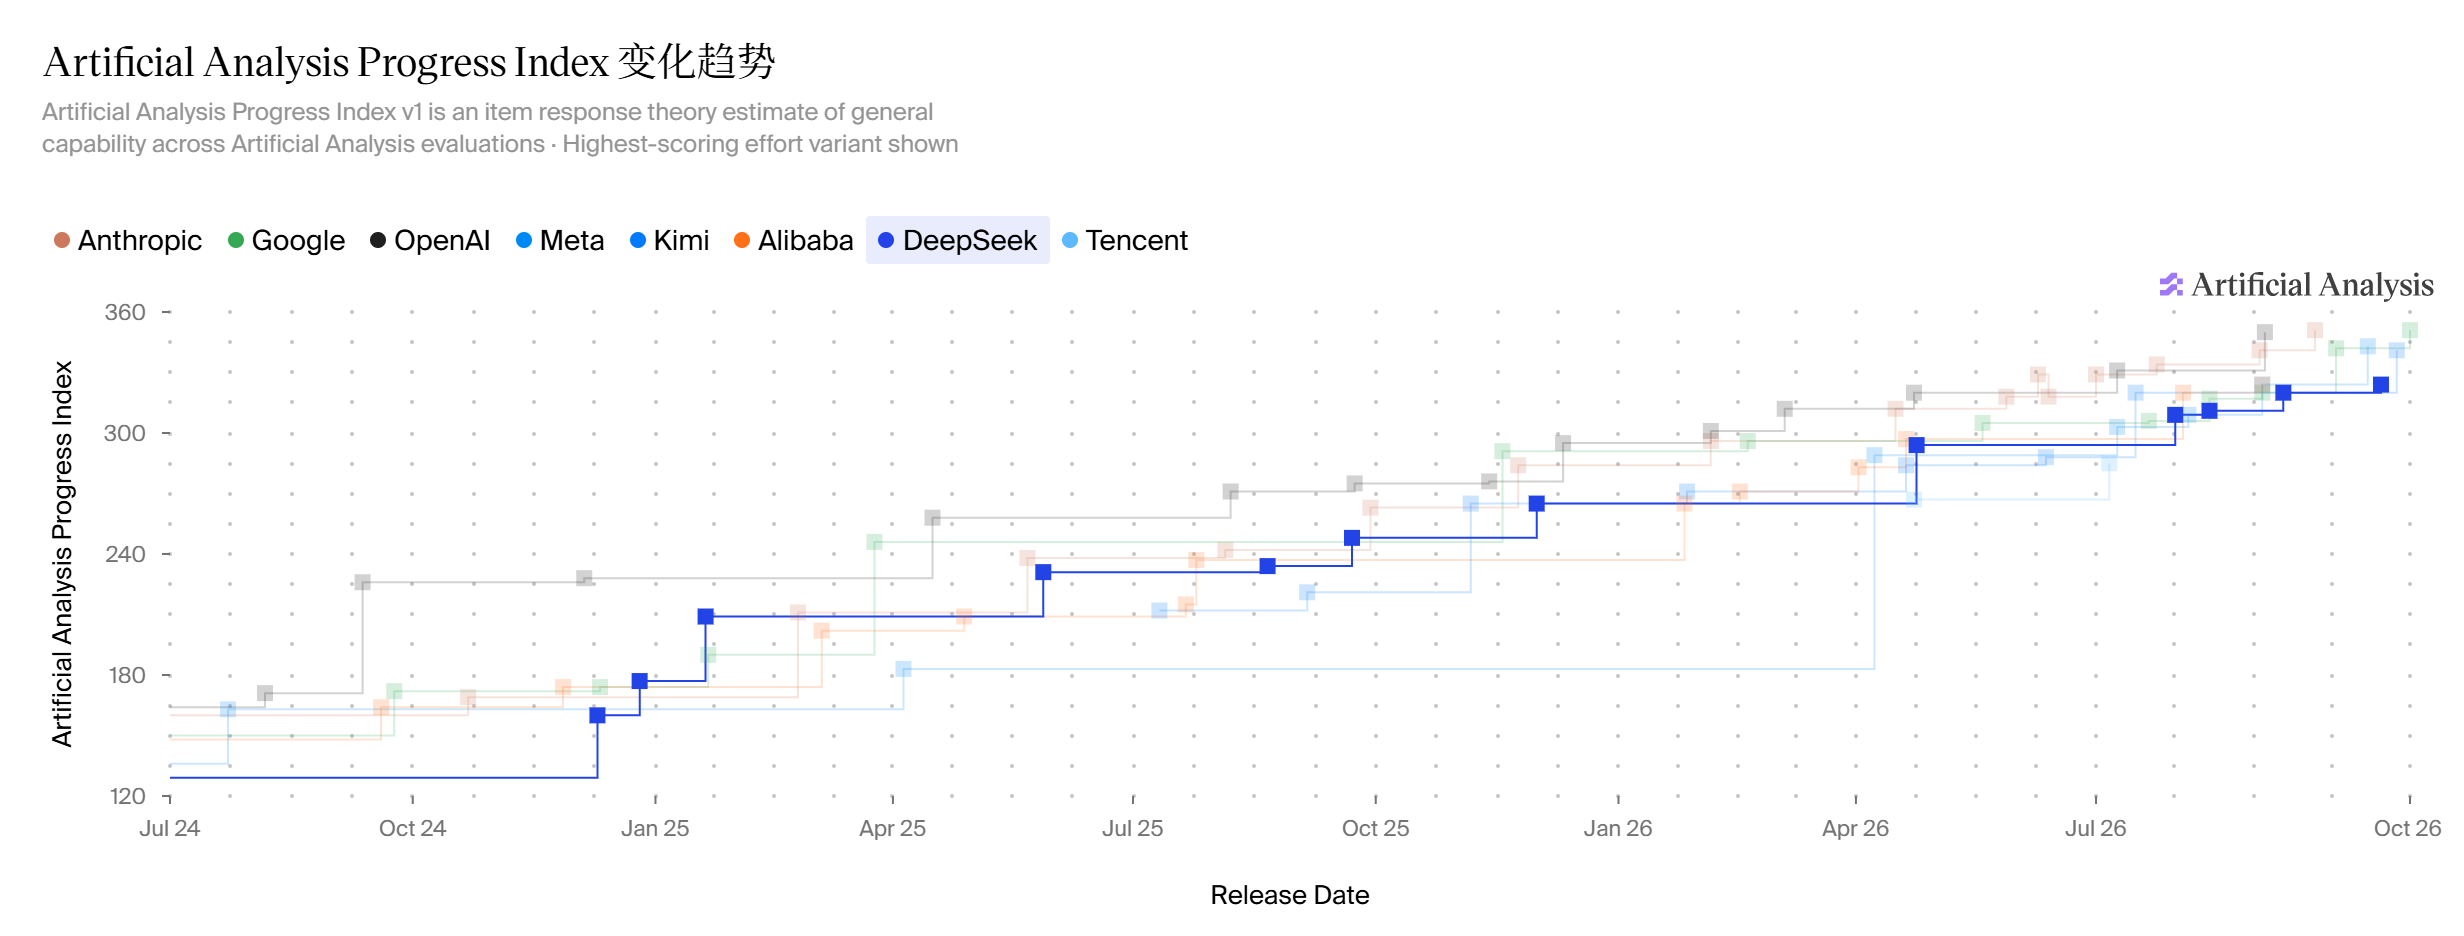
性能:开源模型性能持续追赶闭源,差距稳步缩小
Artificial Analysis Al进度指数,开源模型和闭源模型随时间变化情况 https://artificialanalysis.ai/zh/indexes
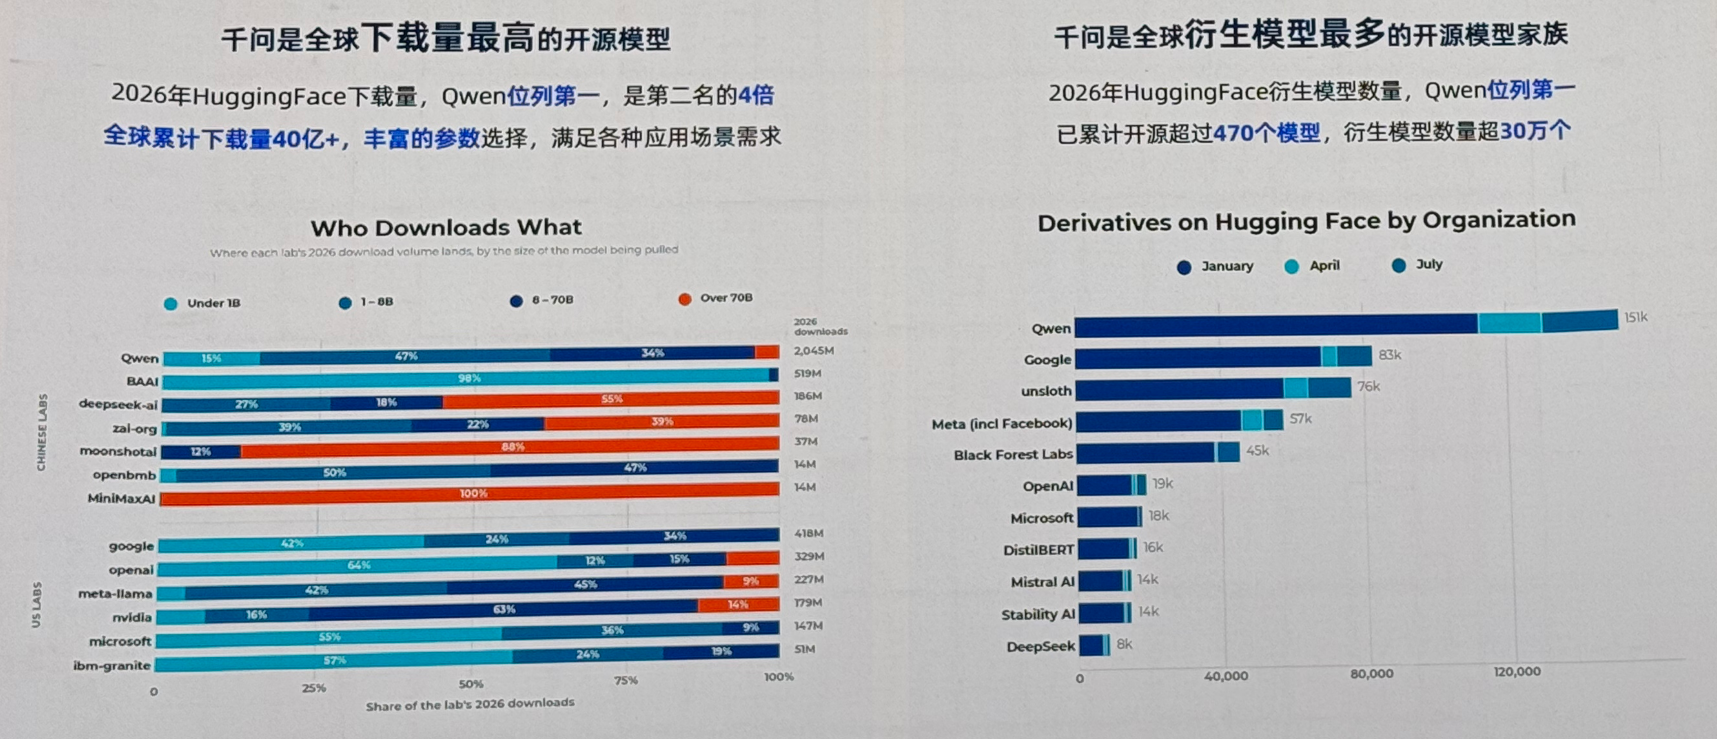
阿里千问是全球最受欢迎的开源模型之一
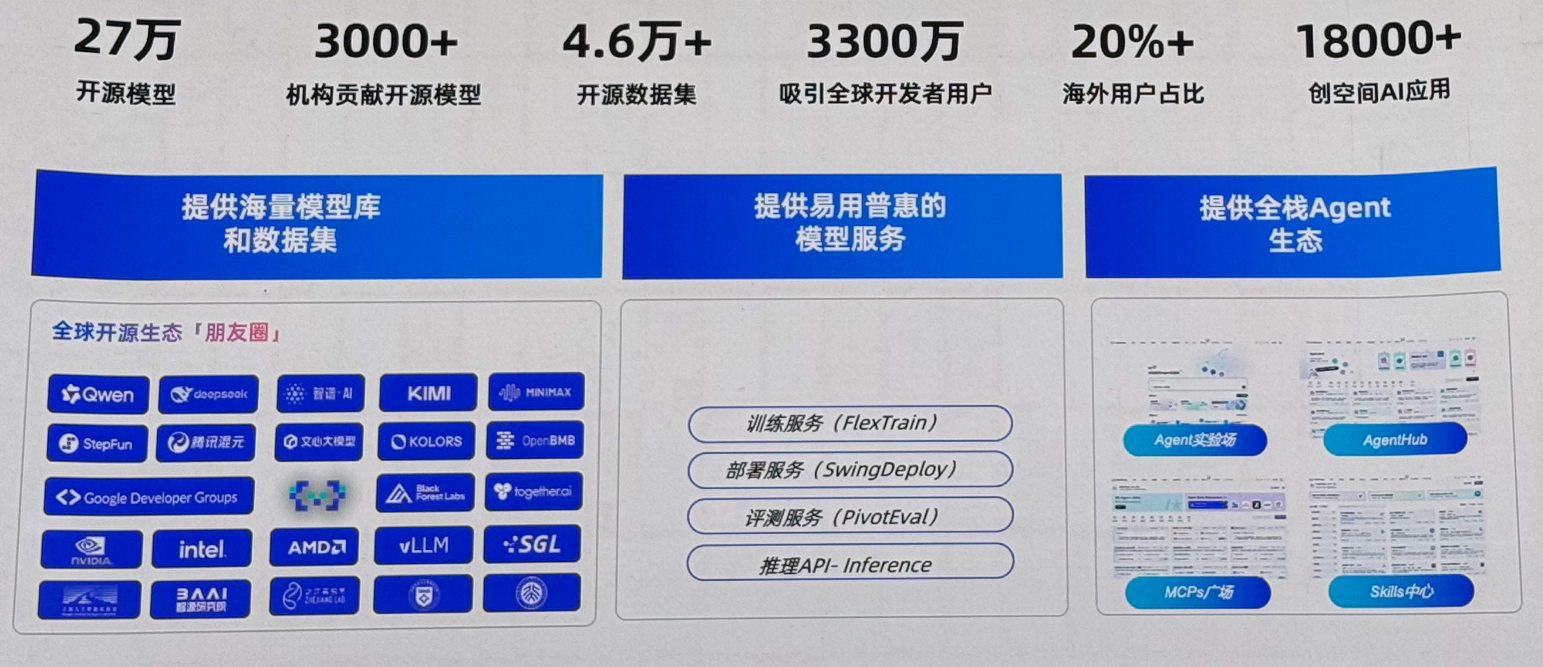
魔搭社区是全国最大AI开源社区
魔塔社区 —— 共享 · 共创 · 共进,构建持续创新的 AI 开源生态 https://www.modelscope.cn/home
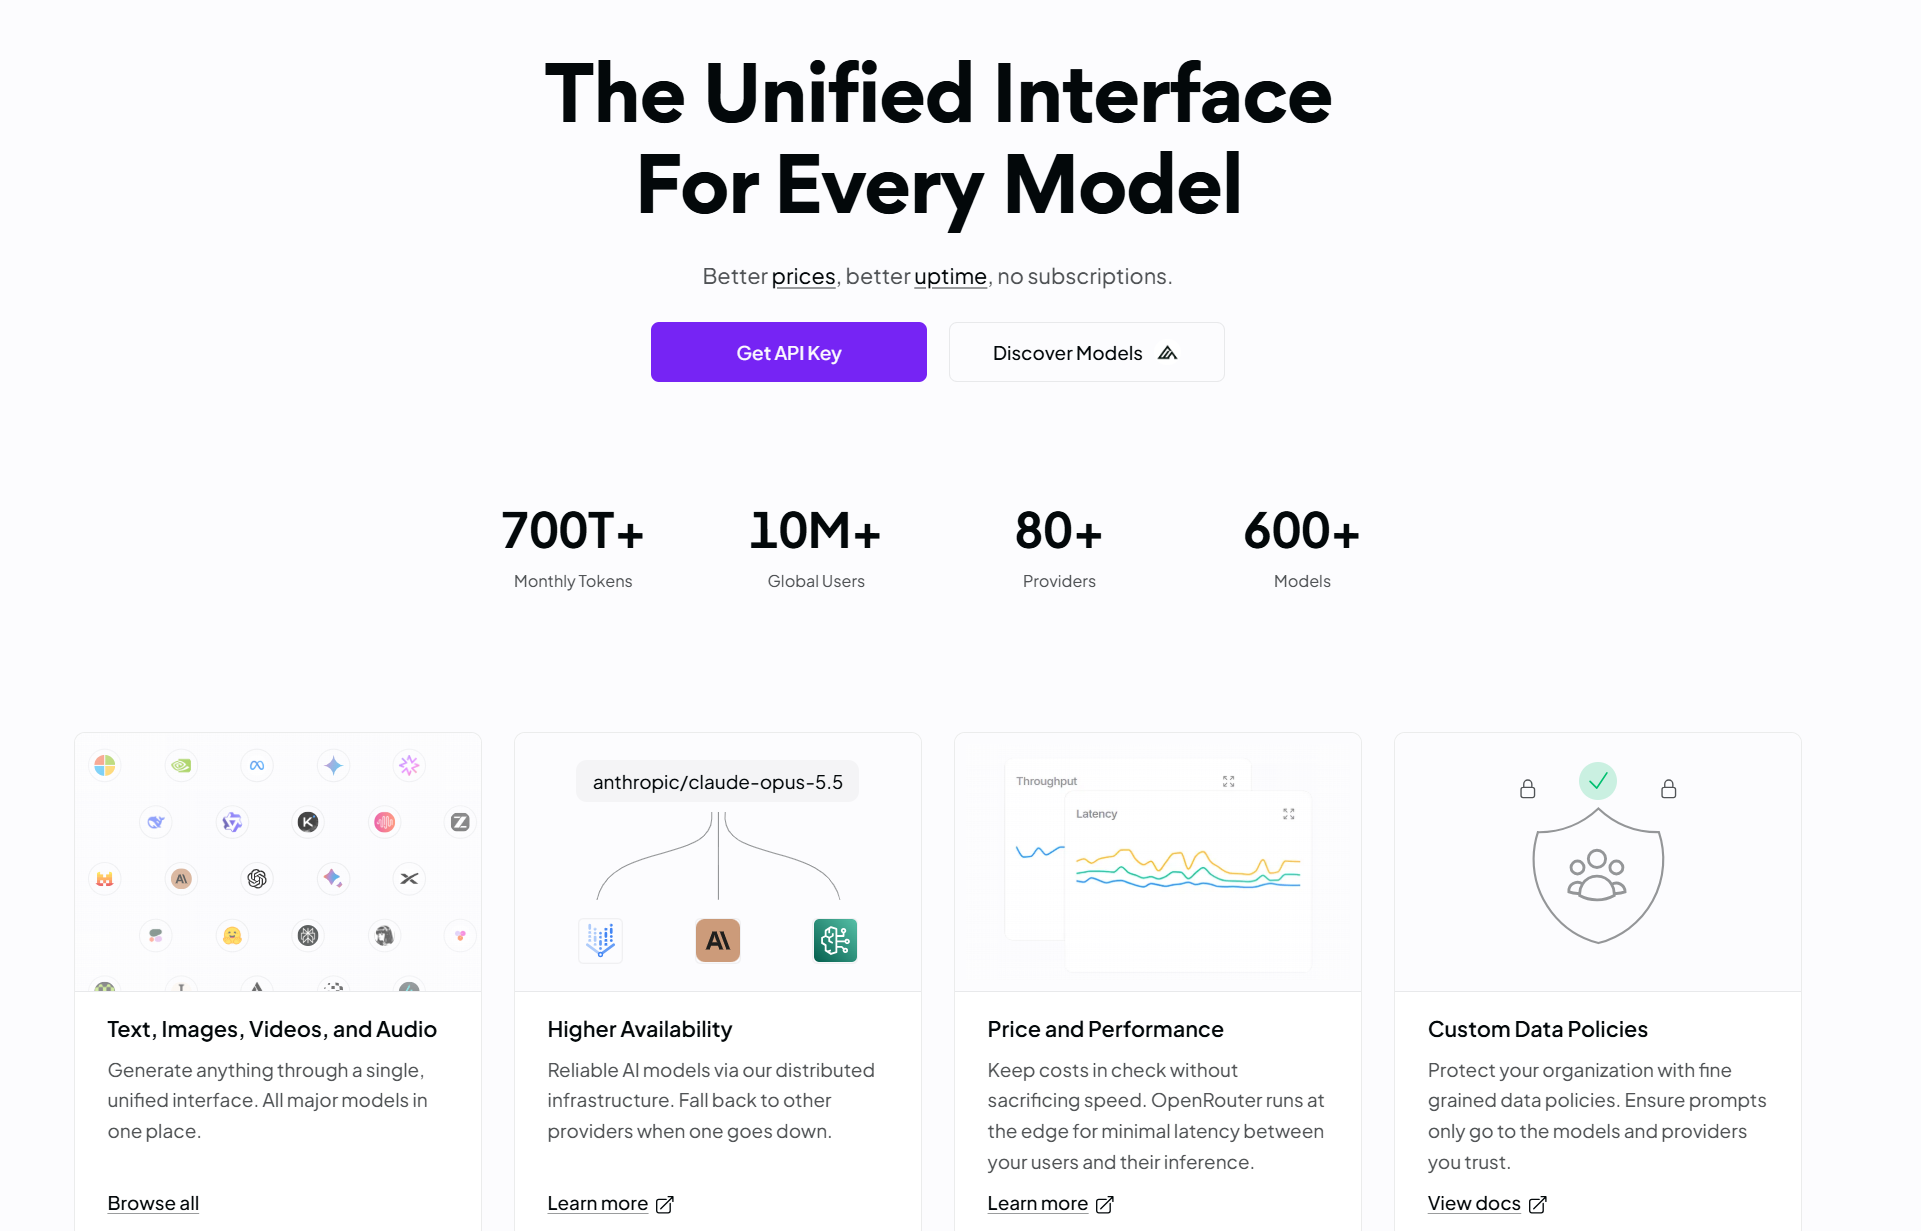
OpenRouter
OpenRouter 是一个连接开发者与海量 AI 模型的统一 API 网关和模型聚合平台。你不需要分别对接 OpenAI、Anthropic、Google 等不同厂商,通过 OpenRouter 的一个接口就能调用和切换数百个模型,并且平台会帮你优化成本和稳定性。 https://openrouter.ai/
备注:与 OpenRouter 作为云端模型聚合网关的角色不同,GPUStack 的定位更底层——它是一个开源的、企业级的 AI 基础设施平台,核心目标是“把任何 GPU 变成高性能的 Token 工厂”。
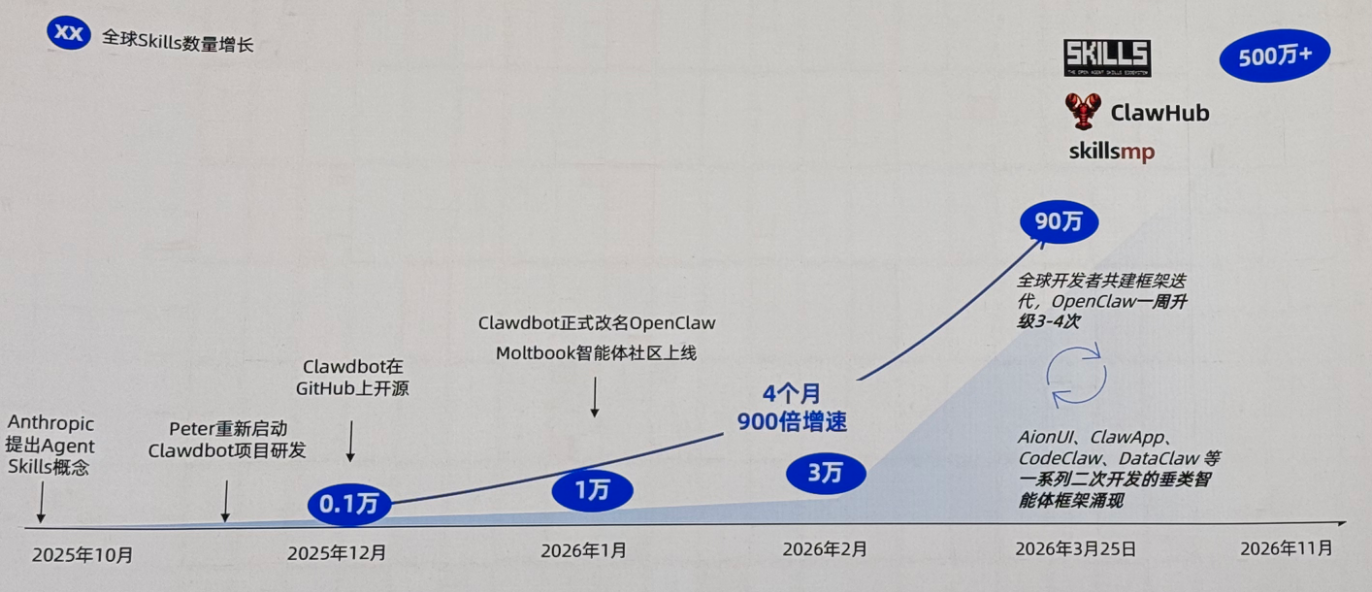
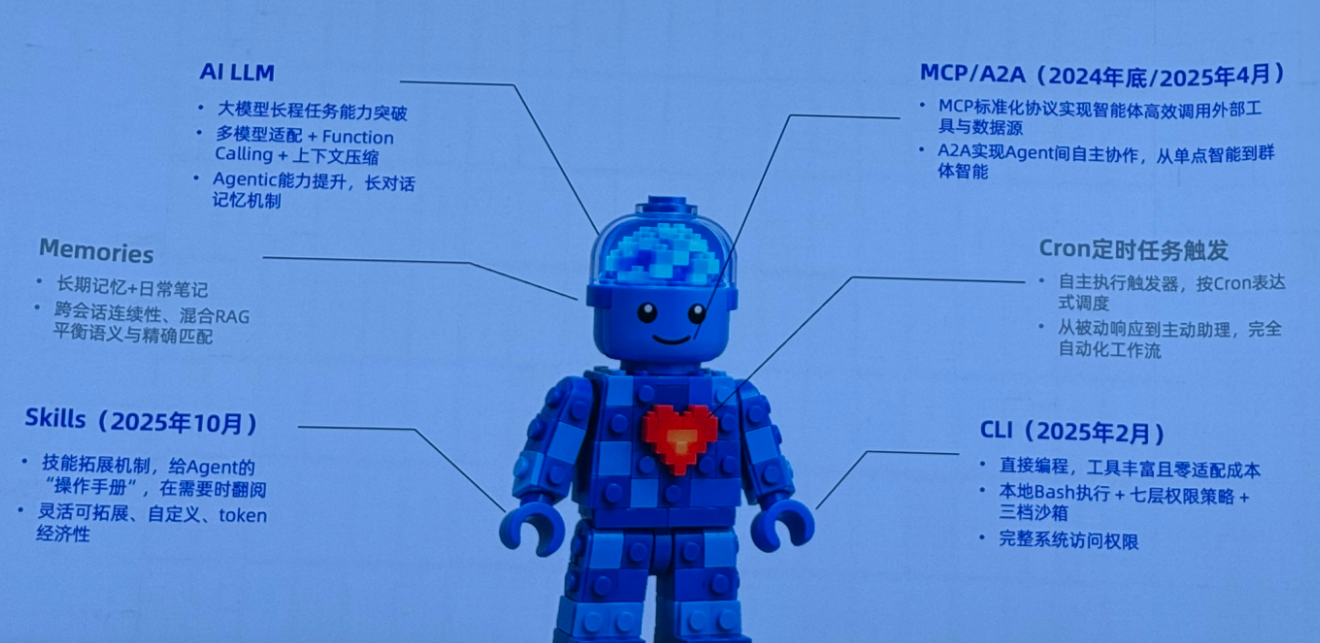
超级智能体:拐点来自于一系列工程的创新组合
备注:让AI找畅销书的绘图内容,提炼SKILL,便于自己的书生成图片。
Skills:智能体成为大众红利的关键,形成新的开源生态