
AI知识分享AI知识分享
✿导航
  • 人工智能
  • 神经网络
  • 机器学习
  • 深度学习
  • 强化学习
  • 自然语言处理
  • 计算机视觉
  • 数学基础
  • 大模型基础
  • 动手学深度学习
  • 理论理解
  • 工程实践
  • 应用开发
  • AI For Everyone
  • AIGC_2024大会
  • AIGC_2025大会
  • Agentic AI
  • Transformer
  • PyTorch
  • HuggingFace
  • LangChain
  • 蒸馏
  • RAG
  • 目标检测
  • MCP
  • Cursor
  • 概念
  • 意图识别
  • 工具
  • 学习路线
  • PyTorch 资料
  • 公式学习
  • PyTorch 基础练习
✿导航
  • 人工智能
  • 神经网络
  • 机器学习
  • 深度学习
  • 强化学习
  • 自然语言处理
  • 计算机视觉
  • 数学基础
  • 大模型基础
  • 动手学深度学习
  • 理论理解
  • 工程实践
  • 应用开发
  • AI For Everyone
  • AIGC_2024大会
  • AIGC_2025大会
  • Agentic AI
  • Transformer
  • PyTorch
  • HuggingFace
  • LangChain
  • 蒸馏
  • RAG
  • 目标检测
  • MCP
  • Cursor
  • 概念
  • 意图识别
  • 工具
  • 学习路线
  • PyTorch 资料
  • 公式学习
  • PyTorch 基础练习
  • 意图识别

    • 应用 - 意图识别
    • 意图识别 - BERT 案例
    • 意图识别 - Chinese-BERT-wwm
    • 意图识别 - NER 标签
  • 工具

    • 工具 - AI代码生成率检测工具
    • 工具 - 契约测试
    • 工具 - MCP 基础
    • 工具 - MCP 基础(英文)
    • 工具 - LangChain 示例

Chinese-BERT-wwm

概念

Chinese-BERT-wwm 是一个基于全词掩码(Whole Word Masking, WWM)技术的中文预训练模型。该项目旨在进一步促进中文信息处理的研究发展,提供了多种中文预训练模型,如 BERT-wwm、BERT-wwm-ext、RoBERTa-wwm-ext 等。这些模型在自然语言处理任务中表现出色,广泛应用于文本分类、命名实体识别、问答系统等领域。

简单来说,原有基于WordPiece的分词方式会把一个完整的词切分成若干个子词,在生成训练样本时,这些被分开的子词会随机被mask。 在全词Mask中,如果一个完整的词的部分WordPiece子词被mask,则同属该词的其他部分也会被mask,即全词Mask。

下述文本展示了全词Mask的生成样例。

说明	        样例
原始文本	    使用语言模型来预测下一个词的probability。
分词文本	    使用 语言 模型 来 预测 下 一个 词 的 probability 。
原始Mask输入	使 用 语 言 [MASK] 型 来 [MASK] 测 下 一 个 词 的 pro [MASK] ##lity 。
全词Mask输入	使 用 语 言 [MASK] [MASK] 来 [MASK] [MASK] 下 一 个 词 的 [MASK] [MASK] [MASK] 。

代码目录解析
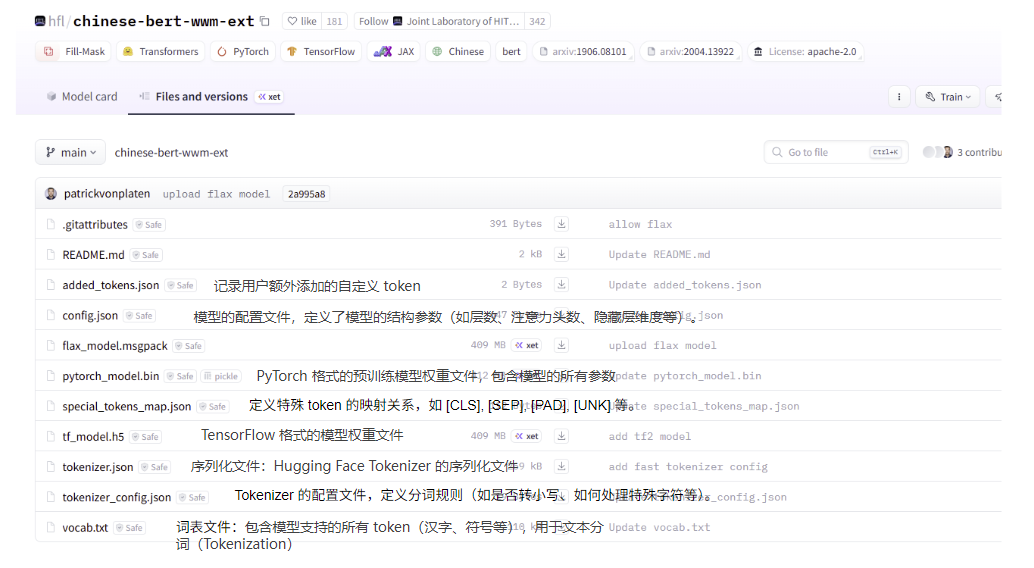
  • 中文BERT-wwm系列模型
  • huggingface的chinese-bert-wwm-ext

实例

  • 基于pytorch的中文意图识别和槽位填充

命名实体识别.md

最近更新: 2025/8/3 19:50
Contributors: klc407073648
Prev
意图识别 - BERT 案例
Next
意图识别 - NER 标签